Author: Ben

  • How to Check If a Page Is Indexed by Google

    How to Check If a Page Is Indexed by Google

    Google Search Console · Index checks

    The reliable way to check if a page is indexed is URL Inspection in Google Search Console: it answers “URL is on Google” or “URL is not on Google” and, crucially, tells you why — the site: operator is only a rough sample.

    Key takeaways
    • URL Inspection is the source of truth; the Page indexing report gives whole-site counts by reason.
    • A missing result in a site: search does not prove a page is unindexed — Google says the operator shows a subset.
    • Third-party bulk checkers guess from search queries; useful for URLs you do not own, wrong in both directions.
    • Indexed ≠ ranking: an indexed page can still sit on page five for your target query.
    • Check Bing too — a page can be indexed in one engine and missing in the other.
    How this was checked. Written against Google’s documentation on URL Inspection, the Page indexing report and search operators, and tested on our own pages in Search Console and Bing Webmaster Tools.
    Short answer

    The reliable way to check if a page is indexed is URL Inspection in Google Search Console: it says “URL is on Google” or “URL is not on Google” and tells you why.

    The site: search is a quick rough check, but it’s incomplete and can mislead. Third-party “index checkers” are guesses built on the same rough signals. For whole-site numbers, use the Page indexing report.

    Four ways to check, ranked by reliability

    • 1. URL Inspection (Search Console) — the source of truth. Paste the URL in the bar at the top. You’ll see whether it’s on Google, the last crawl date, the user-declared and Google-selected canonical, and the exact reason if it’s not indexed.
    • 2. Page indexing report (Search Console) — how many of your pages are indexed and, grouped by reason, which ones aren’t. Best for spotting patterns across a site.
    • 3. site: search — type site:yoursite.com/page-url into Google. If it shows up, it’s indexed. If it doesn’t, it might still be indexed — Google says the site: operator doesn’t show every indexed URL.
    • 4. Third-party index checkers — convenient for bulk lists of URLs you don’t own (like backlinks), but they rely on search queries and can be wrong in both directions.
    Don’t forget the live test
    URL Inspection shows Google’s last known version. Click Test live URL to check whether the page as it is now can be indexed — useful right after you fix a noindex or a robots.txt block.
    Method Reliability Works for Tells you why?
    URL Inspection (GSC) Definitive Your verified sites Yes
    Page indexing report Definitive, site-wide Your verified sites Yes, grouped
    site: search Rough sample Any site No
    Third-party checkers Approximate Any URL list No

    Reading the URL Inspection result

    URL IS ON GOOGLE

    Indexed

    Means: the page can appear in results. Ranking is a separate question.

    URL IS NOT ON GOOGLE

    Not indexed

    Means: check the reason under Page indexing — each status has a specific fix.

    Common reasons and their guides: Crawled / Discovered – currently not indexed, Excluded by noindex, Duplicate without user-selected canonical, Soft 404 and Page with redirect. “URL is unknown to Google” simply means Google hasn’t found it yet.

    Checking Bing too

    Bing Webmaster Tools has its own URL Inspection with the same idea: indexed or not, and why. It’s worth checking both — a page can be indexed in one and missing in the other. See our Bing Webmaster Tools guide.

    Our take
    Stop refreshing site: searches. One URL Inspection gives you a definitive answer and the reason — which is the only thing you can actually act on.

    FAQ

    Why does site: show fewer pages than Search Console?

    The site: operator is a rough sample, not a full list. Search Console’s Page indexing report is the accurate count.

    Can I check if someone else’s page is indexed?

    Not with URL Inspection, which only works for properties you’ve verified. For other sites, a site: search or a third-party checker is the best you can do.

    URL Inspection says indexed, but I can’t find my page. Why?

    Indexed doesn’t mean ranking. The page is eligible to appear, but it may rank low for the queries you’re trying. Search for a unique sentence from the page in quotes to confirm.

    How often does the indexing status update?

    URL Inspection reflects Google’s latest crawl of that page. The Page indexing report is updated periodically and can lag by several days.

    Can I check indexing for a whole list of URLs at once?

    For your own site, the Page indexing report covers everything. For external lists, bulk checkers approximate; expect some false negatives.

    Does “URL is on Google” guarantee my page shows in results?

    It means the page is eligible. Whether it appears depends on ranking; search a unique quoted sentence from the page to confirm it can surface.

    iP
    IndexUrePoint is an independent guide to getting your pages found and indexed — Google, Bing, and AI search. We test tools ourselves and say plainly when something doesn’t work. Spotted an error? Tell us via the contact page; we’ll fix it and note the date.

  • How to Submit Your Website to Google (Free, in 15 Minutes)

    How to Submit Your Website to Google (Free, in 15 Minutes)

    Lees deze gids in het Nederlands →

    Google Search Console · Getting started

    You submit a website to Google through Google Search Console — add the property, verify ownership, submit your XML sitemap and request indexing for key pages. It is free, takes about 15 minutes, and there is no paid alternative worth buying.

    Key takeaways
    • There is no public “Submit URL” form anymore, and the sitemap ping endpoint was retired — Search Console is the way in.
    • A domain property covers http, https, www and subdomains in one go; it needs a DNS TXT record.
    • Request indexing has a small daily quota — we hit “quota exceeded” after six requests on a fresh property.
    • Submitting speeds up discovery; whether pages get indexed still depends on allowed → reachable → worth keeping.
    • Set up Bing the same day: ten extra minutes covers the index behind Copilot and much of ChatGPT search.
    How this was checked. Written against Google’s Search Console and sitemap documentation, and done step by step on this site: we added the domain property, verified it via DNS, submitted the sitemap and requested indexing for our key pages.
    Short answer

    You “submit” a website to Google through Google Search Console: add your site, verify ownership, submit your XML sitemap, and use URL Inspection → Request indexing for your most important pages. It’s free and takes about 15 minutes.

    There is no separate “submit URL” form anymore, and the old sitemap ping was retired. Anyone charging you to “submit your site to Google” is selling something Google gives away.

    Submit your website to Google in 4 steps

    • 1. Add a property in Google Search Console (search.google.com/search-console).
    • 2. Verify ownership. For a domain property, add the TXT record Google gives you in your domain’s DNS settings (at your registrar or host). Verification usually succeeds within minutes once the record is live.
    • 3. Submit your sitemap under Indexing → Sitemaps. WordPress with Yoast or Rank Math: /sitemap_index.xml. WordPress without an SEO plugin: /wp-sitemap.xml.
    • 4. Request indexing for key pages. Paste the URL into the inspection bar at the top, then click Request indexing. There’s a daily limit — use it for your homepage and most important pages; the sitemap covers the rest.
    From our own setup
    On this site, the sitemap flipped from “Couldn’t fetch” to “Success” within minutes, and Search Console showed a “quota exceeded” message after six indexing requests on a brand-new property. That’s normal — don’t try to push every URL by hand.

    Domain or URL-prefix property?

    DOMAIN

    Everything in one

    Covers: http and https, www and non-www, all subdomains. Needs DNS verification. Our recommendation.

    URL-PREFIX

    One exact version

    Covers: only the exact prefix you enter. Can be verified with an HTML tag or file — handy if you can’t edit DNS.

    Property type Covers Verification Best for
    Domain All protocols & subdomains DNS TXT record Most sites (our pick)
    URL prefix One exact prefix only HTML tag/file, Analytics, DNS No DNS access, or subfolder-only

    What happens after you submit

    Submitting doesn’t index anything by itself. It tells Google where your pages are. Google then crawls them on its own schedule and decides which ones are worth keeping. For a new site, days to several weeks is normal — see how long Google takes to index.

    Our take
    Submitting is the easy 15 minutes. What decides whether you actually get indexed is whether your pages are allowed, reachable and worth keeping — the checklist in why isn’t Google indexing my site.

    FAQ

    Do I have to submit my site to Google to appear in search?

    No. Google finds sites through links too. But submitting via Search Console speeds up discovery and gives you the data to fix problems, so it’s always worth doing.

    Is there still a “Submit URL” tool?

    Not as a public form. The replacement is URL Inspection → Request indexing inside Search Console, which requires a verified property.

    Can I still ping Google with my sitemap?

    No. Google deprecated the sitemap ping endpoint. Submit the sitemap in Search Console and list it in robots.txt instead.

    How many pages can I request indexing for?

    There’s a daily quota per property, and Google doesn’t publish a fixed number. Prioritise your key pages and let the sitemap handle the rest.

    How much does it cost to submit a website to Google?

    Nothing. Search Console, sitemap submission and Request indexing are free. Services charging for “Google submission” resell a free process.

    How long after submitting does my site appear in Google?

    Discovery can start within hours, but indexing typically takes days to a few weeks for new sites, depending on links and content quality.

    Do I need to resubmit my sitemap when I publish new posts?

    No. Your SEO plugin updates the sitemap automatically and Google rechecks it on its own schedule; one submission is enough.

    iP
    IndexUrePoint is an independent guide to getting your pages found and indexed — Google, Bing, and AI search. We test tools ourselves and say plainly when something doesn’t work. Spotted an error? Tell us via the contact page; we’ll fix it and note the date.

  • Bing Webmaster Tools: The Complete 2026 Setup Guide

    Bing Webmaster Tools: The Complete 2026 Setup Guide

    Lees deze gids in het Nederlands →

    Bing · Webmaster Tools · 2026 guide

    Bing Webmaster Tools is Microsoft’s free counterpart to Google Search Console: it shows how Bing crawls, indexes and ranks your site — and, since February 2026, how often Microsoft Copilot cites your pages in AI answers.

    Key takeaways
    • Setup takes about 10 minutes: add the site (or import it from Search Console), verify, submit the sitemap, connect IndexNow.
    • Bing’s own search share is small — 4.5% worldwide in August 2026 (StatCounter) — but its index reaches far beyond bing.com.
    • In a 100-query study, 87% of ChatGPT search citations matched Bing’s top results (Seer Interactive, 2025).
    • The AI Performance report (public preview since 10 February 2026) shows citations in Copilot and Bing’s AI summaries — data Google Search Console doesn’t break out.
    • IndexNow pushes new URLs to Bing in seconds; Microsoft said it accounted for 17% of new URLs clicked in Bing results.
    How this was checked. First-hand: on 24 September 2026 we added indexurepoint.com to Bing Webmaster Tools, verified it with the meta-tag method, submitted our sitemap index and connected IndexNow. Everything else is sourced to Microsoft’s own documentation or named studies, linked inline. Reddit threads are quoted only from their public titles and search snippets.

    What is Bing Webmaster Tools?

    Bing Webmaster Tools is a free dashboard from Microsoft for site owners. It tells you which of your pages Bing has found and indexed, which queries you appear for, which sites link to you, and what technical problems Bing ran into while crawling.

    Microsoft’s own Webmaster Guidelines now describe how Bing surfaces content “across Bing search experiences, Copilot, and grounding API results” — in other words, the same index feeds classic search, Microsoft’s AI assistant and third parties that ground their answers on Bing.

    Why does Bing matter in 2026 if Google has 91% share?

    Because the Bing index is used far beyond bing.com. Google still holds about 91% of worldwide search and Bing about 4.5% (StatCounter, August 2026), but AI assistants change the maths.

    4.5%Bing’s worldwide search share, Aug 2026 — StatCounter
    87%of ChatGPT search citations matched Bing’s top results (100 queries, 500+ citations) — Seer Interactive
    17%of new URLs clicked in Bing results came via IndexNow — Fabrice Canel, Microsoft, via Search Engine Land
    10,000URLs per day: the maximum manual submission quota — Search Engine Journal
    18,100monthly US searches for “bing webmaster tools”, +124% year on year (DataForSEO, Sept 2026)

    The Seer study compared ChatGPT’s citations with Google and Bing results for the same questions: Bing matched 87%, Google 56%. It isn’t the whole story — experiments reported by Semrush suggest paid ChatGPT also draws on Google — but the takeaway is simple: if Bing can’t index you, you’re missing from a large share of AI answers. That’s also why we treat Bing as a pillar of answer engine optimization, not an afterthought.

    How do you set up Bing Webmaster Tools? (10 minutes)

    Microsoft’s Getting Started Checklist lists the same core steps. Here’s how they played out on this site.

    Step 1 — Sign in

    Go to bing.com/webmasters and sign in with a Microsoft, Google or Facebook account. No separate registration is needed.

    Step 2 — Add your site

    You get two choices. Import from Google Search Console is fastest: your verified properties and their sitemaps come across without separate verification, but you grant Bing read access to your Search Console data. Add manually means entering your URL and verifying yourself. We chose manual, to keep the accounts separate. If you haven’t set up Search Console yet, start with how to submit your website to Google.

    Step 3 — Verify ownership

    Three methods: an XML file (BingSiteAuth.xml) in your site root, an msvalidate.01 meta tag on your homepage, or a CNAME record in DNS. On WordPress the meta tag is simplest — Yoast SEO has a field for it. We added the tag, clicked Verify, and the site appeared in the dashboard straight away.

    Step 4 — Submit your sitemap

    Open Sitemaps → Submit sitemap and enter your sitemap URL — with Yoast or Rank Math usually /sitemap_index.xml. Ours showed “Processing” within seconds. If Bing reports an error, the causes are the same as on Google: see sitemap could not be read.

    Step 5 — Connect IndexNow

    Install the official IndexNow plugin (or enable IndexNow in your SEO plugin) so every new or updated URL is pushed to Bing instantly. By the time of writing, this site had sent 100 IndexNow submissions with zero failures. Details in what is IndexNow.

    How does Bing Webmaster Tools compare to Google Search Console?

    They overlap on the basics and differ on the extras. Bing is more generous with free research data; Google has the bigger audience.

    Feature Bing Webmaster Tools Google Search Console
    Search performance (clicks, impressions, queries) Yes Yes
    URL inspection Yes Yes
    AI citation reporting Yes — AI Performance (public preview) No separate report; AI features are part of Performance
    Backlink data Yes — referring domains and anchors Basic Links report
    Keyword research Yes, from Bing data No
    On-demand site audit Yes — Site Scan No
    Instant URL push IndexNow (automatic) Request indexing (manual, daily limit)
    Verification XML file, meta tag, CNAME, or import from Google DNS, HTML file, meta tag, Analytics, Tag Manager

    Practitioners notice the extras too: one r/bigseo thread titled “Anyone here actively using Bing Webmaster Tools?” includes a reply calling the backlink data “surprisingly good”.

    What does the AI Performance report show?

    Microsoft introduced AI Performance on 10 February 2026 as a public preview. It covers Microsoft Copilot, AI-generated summaries in Bing and select partner integrations, with five views: total citations, average cited pages, grounding queries, page-level citation activity and trends over time. On 13 October 2026 Microsoft added Topics Portfolio (beta), which groups those grounding queries into broader themes.

    Its limits matter. As Search Engine Land noted, the metrics reflect citation frequency only — no clicks, no traffic, and no indication of how prominently you were used. Treat it as a visibility signal, then check real visits in your analytics. To raise your citation count, apply the playbook in how to get cited in AI search, and make sure you aren’t blocking Microsoft’s crawler — see AI crawlers and robots.txt.

    How does IndexNow fit in?

    Bing Webmaster Tools shows what Bing knows about your site; IndexNow is how you tell Bing about changes the moment they happen. Instead of waiting for Bingbot to recrawl, your site pings Bing with each new, updated or deleted URL, and the IndexNow section of the dashboard lists what was received.

    Manual URL submission still exists — Bing raised the daily quota from 10 to up to 10,000 URLs, depending on how long a site has been verified (Search Engine Journal) — but IndexNow does the same job automatically. Google doesn’t participate in IndexNow; for Google you still rely on sitemaps and internal links.

    Can you connect Bing Webmaster Tools to ChatGPT, Claude or BigQuery?

    Not with an official one-click connector: Microsoft publishes none for ChatGPT, Claude, BigQuery, Google Sheets, Looker Studio or Power BI (checked 17 October 2026). What Microsoft does offer is the Bing Webmaster API, and every working connection runs through it.

    You get access in two ways: OAuth 2.0, which Microsoft recommends for apps, or an API key. For the key, open Bing Webmaster Tools, click Settings (top right) → API Access → Generate API Key. Only one key can be generated per user. The key belongs to your user account, not to one site, so treat it like a password. If the key leaks, delete it in Bing Webmaster Tools and generate a new one; every app that still uses the old key stops working until you give it the new key.

    The API covers the same data as the main reports. Useful methods in the official reference include GetQueryStats and GetPageStats (traffic for top queries and pages), GetPageQueryStats, GetRankAndTrafficStats, GetCrawlStats, GetCrawlIssues, GetUrlInfo, GetKeywordStats, SubmitUrl and SubmitUrlBatch. The AI Performance report is not in the API reference, so citation data stays in the dashboard for now.

    Connect to Official connector? Route that works
    ChatGPT No A custom GPT action or your own script that calls the API with your key
    Claude / Claude Code No An MCP server that wraps the API (community-built, see below) or a script Claude Code runs for you
    BigQuery No A scheduled script (for example a Cloud Run job) that pulls GetQueryStats and GetPageStats and loads them into a table
    Google Sheets No Apps Script with UrlFetchApp calling the API, or import the CSV from the Download button in Search Performance
    Looker Studio No Third-party connectors (some paid), or Looker Studio on top of your BigQuery table
    Power BI No Power Query “From Web” against the API, or a dataset you fill with a script
    About “Bing Webmaster Tools MCP servers”
    The MCP servers you find on GitHub for Claude and other assistants are built by individual developers, not by Microsoft. They use your API key, usually through an environment variable such as BING_WEBMASTER_API_KEY. Read the code before you install one, and keep the key out of shared configs and code repositories.

    For most sites the simplest useful setup is a weekly script that pulls query and page stats into a sheet or a BigQuery table next to your Search Console data. That gives you a side-by-side view of which pages Google and Bing actually index and which queries each engine sends.

    What goes wrong — and how do you fix it?

    • “Is it even worth it?” — a common doubt, e.g. this r/growmybusiness thread. Ten minutes of setup buys you Bing, Copilot and part of ChatGPT’s source pool. Yes, it’s worth it.
    • Indexed in the dashboard, missing in search. One r/bing user reported their site was deindexed while the portal still showed it as indexed. Use URL Inspection’s live check, and confirm with a site: search on Bing — the same method as in how to check if a page is indexed.
    • Bingbot blocked. A firewall or robots.txt rule that lets Googlebot in but not Bingbot silently keeps you out. Check both — see blocked by robots.txt.
    • Verification disappears. Bing re-checks verification. Remove the meta tag during a redesign and you lose access.
    • Pages found but not indexed. Bing, like Google, skips thin or duplicate pages. The fixes in crawled vs. discovered and orphan pages apply here too.
    • Duplicate IndexNow pings. Several plugins submitting the same URLs wastes quota. Use one method.
    Our take
    Bing Webmaster Tools is the cheapest visibility win in SEO right now: ten minutes of setup, free research data, and a direct line into the index behind Copilot and much of ChatGPT search. Set it up the same day as Search Console, and let IndexNow keep it current.

    FAQ

    Is Bing Webmaster Tools free?

    Yes. Every feature, including Site Scan, backlink data, keyword research and the AI Performance report, is free with a Microsoft, Google or Facebook sign-in.

    Should I connect my site to Bing Webmaster Tools if I already use Google Search Console?

    Yes. The two tools cover different indexes. Bing’s feeds Bing search, Microsoft Copilot and partners, and it’s the only one that reports AI citations separately.

    Can I import my site from Google Search Console?

    Yes. The import adds your verified Search Console sites and their sitemaps without separate verification, after you grant Bing read access to your Search Console data.

    Does anyone still use Bing?

    Directly, about 4.5% of searches worldwide in August 2026 according to StatCounter. Indirectly, far more: Bing’s index feeds Microsoft Copilot and is a major source for ChatGPT search citations.

    How many URLs can I submit to Bing per day?

    Manual submission allows up to 10,000 URLs per day, depending on how long your site has been verified and other signals. IndexNow submissions are separate and automatic.

    How long does Bing take to index a new site?

    With a sitemap and IndexNow, Bing usually discovers new URLs quickly. Whether it indexes them depends on quality and trust; new sites can take days to weeks.

    Does the AI Performance report show clicks from Copilot?

    No. It shows citation frequency, cited pages and grounding queries, but not clicks or traffic. Check referral traffic from Copilot in your analytics.

    Why is my site indexed in Google but not in Bing?

    Common causes are a Bingbot block in robots.txt or a firewall, no submitted sitemap, or content Bing judges thin. Check URL Inspection in Bing Webmaster Tools for the specific reason.

    Can I connect Bing Webmaster Tools to ChatGPT?

    Not through an official connector. Generate an API key under Settings → API Access and call the Bing Webmaster API from a custom GPT action or your own script.

    Is there an official Bing Webmaster Tools MCP server for Claude or Claude Code?

    No. The MCP servers on GitHub are community projects that wrap the official Bing Webmaster API with your API key. Review the code before installing one.

    Can I export Bing Webmaster Tools data to BigQuery or Google Sheets?

    Not natively. A scheduled script that calls GetQueryStats and GetPageStats can load the data into BigQuery or a sheet; the AI Performance report is not available through the API.

    B
    Ben runs IndexUrePoint and manages several websites in Google Search Console and Bing Webmaster Tools, including this one. He tests every setup described here on a live site before writing about it. Spotted an error? Tell us via the contact page; we’ll fix it and note the date.
  • Pagina met omleiding in Search Console: normaal of een probleem?

    Pagina met omleiding in Search Console: normaal of een probleem?

    Read this guide in English →

    Google Search Console · Omleidingen

    “Pagina met omleiding” betekent dat de URL bezoekers doorstuurt, waardoor Google de bestemming indexeert — meestal precies de bedoeling. De kwade tweeling “Fout met omleiding” (lussen, lange ketens) moet je wél altijd repareren.

    Belangrijkste punten
    • Een lange lijst “Pagina met omleiding” na een https-migratie of herontwerp is een teken dat het goed ging.
    • Grijp alleen in als doorverwijzende URL’s in je sitemap staan, intern gelinkt worden of verkeerd uitkomen.
    • “Fout met omleiding” = lus, te lange keten of kapotte stap — test met een live URL-inspectie.
    • Permanente verhuizingen op 301/308, en elke redirect in één stap: A→C, niet A→B→C.
    • Volgens Google kosten server-side redirects geen PageRank; ketens verspillen alleen crawlwerk.
    Hoe dit is gecontroleerd. Geschreven op basis van Google’s documentatie over het rapport Pagina-indexering en zijn richtlijnen over doorverwijzingen en verhuizingen van sites.
    Kort antwoord

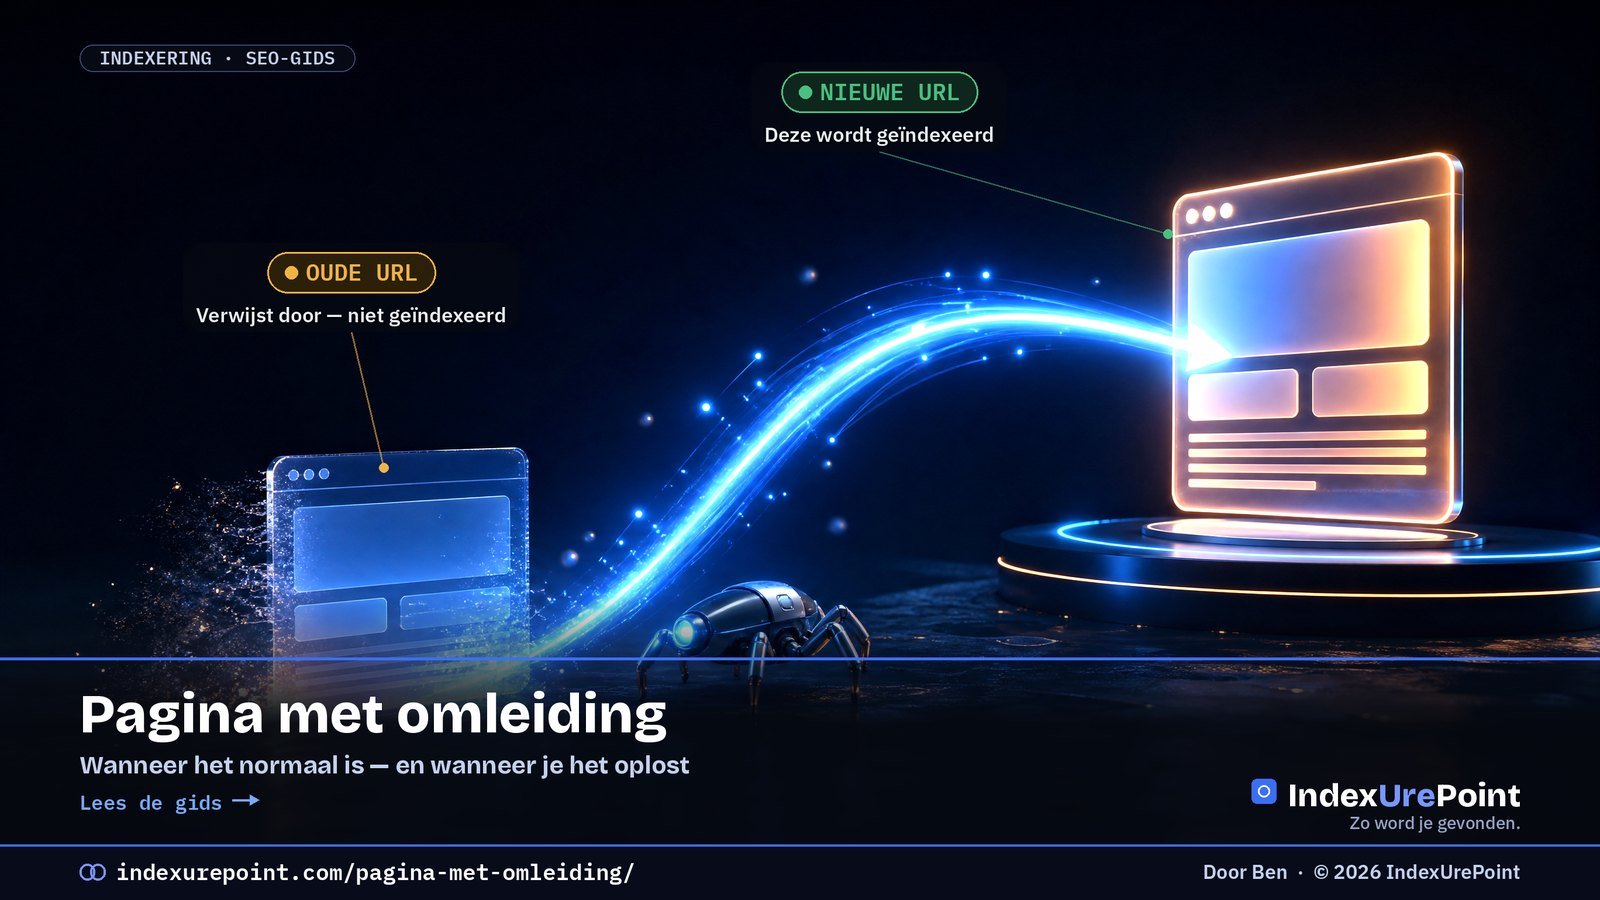
    “Pagina met omleiding” betekent dat deze URL doorverwijst naar een andere, dus Google indexeert de bestemming en niet deze URL. Dat is normaal en meestal precies goed.

    Actie is alleen nodig als een doorverwijzende URL nog in je sitemap staat, intern gelinkt wordt, of naar de verkeerde plek gaat. De boze tweeling, “Fout met omleiding” — lussen, lange ketens, kapotte doelen — moet je altijd oplossen.

    Wat “Pagina met omleiding” betekent

    OUDE URL

    Verwijst door

    Status: “Pagina met omleiding” — bewust niet geïndexeerd.

    NIEUWE URL

    Wordt geïndexeerd

    Status: hoort geïndexeerd te zijn en neemt de signalen van de oude URL over.

    Normaal of oplossen?

    • Normaal: http → https, met of zonder www, oude slugs na het hernoemen van een bericht, verwijderde pagina’s doorverwezen naar een echte vervanger.
    • Oplossen: doorverwijzende URL’s in je XML-sitemap. Een sitemap hoort alleen definitieve, indexeerbare URL’s te bevatten.
    • Oplossen: menu’s en interne links die naar een doorverwijzende URL wijzen. Link direct naar de eindbestemming.
    • Oplossen: een pagina die je wilt laten ranken maar onverwacht doorverwijst — vaak een pluginregel of taal-doorverwijzing.
    Situatie Status Actie
    http → https, www-normalisatie, nieuwe slugs Pagina met omleiding Geen — werkt zoals bedoeld
    Doorverwijzende URL in sitemap of menu Pagina met omleiding Sitemap/links naar de eind-URL wijzen
    Lus of keten zonder einde Fout met omleiding Op één laag oplossen; keten platslaan
    Verwijderde pagina’s massaal naar home Soft 404 Naar echte equivalenten, of 404/410

    “Fout met omleiding” — die moet je oplossen

    Deze aparte status betekent dat Google de doorverwijzing niet kon afmaken: een te lange keten, een lus, een URL die te lang werd, of een lege of kapotte URL in de keten. Test de URL met URL-inspectie en laat elke oude URL in één 301-stap naar de eindbestemming gaan.

    Let op lussen
    Lussen ontstaan vaak doordat twee systemen elkaar tegenwerken, bijvoorbeeld een CDN dat https afdwingt terwijl de server http afdwingt. Los het op één plek op.
    Onze mening
    Een lange lijst “Pagina met omleiding” na een verhuizing naar https of een nieuw ontwerp betekent dat het goed ging. Steek je energie in de sitemap, interne links en eventuele “Fout met omleiding”-meldingen. Stuur verwijderde pagina’s niet allemaal naar de homepage — dat ziet Google vaak als soft 404.

    Een uitgewerkt voorbeeld

    Stel: je hernoemt een artikel van /seo-tips/ naar /seo-tips-2026/. WordPress maakt automatisch een redirect van de oude naar de nieuwe slug. In Search Console verschijnt de oude URL daarna als “Pagina met omleiding” — correct, geen actie nodig. Wél actie nodig: je interne links en eventuele menu-items nog naar /seo-tips/ laten wijzen. Elke klik en elke crawl maakt dan een extra stap. Werk je een jaar later de titel opnieuw bij naar /seo-tips-2027/, controleer dan of de oudste URL rechtstreeks naar de nieuwste gaat, en niet via de tussenversie — zo houd je elke omleiding op één stap en blijft “Fout met omleiding” buiten de deur.

    Veelgestelde vragen

    Moet ik “Pagina met omleiding” oplossen?

    Meestal niet. Alleen als de URL in je sitemap staat, intern gelinkt wordt, of een pagina is die je eigenlijk geïndexeerd wilde hebben.

    Moet ik hier “Oplossing valideren” gebruiken?

    Niet als de doorverwijzingen bewust zijn. De URL’s blijven in het rapport staan zolang Google ze kent, en dat is prima.

    Verlies ik rankingwaarde door doorverwijzingen?

    Google heeft gezegd dat 301- en andere server-side doorverwijzingen geen PageRank kosten. Ketens vertragen wel het crawlen, dus houd het bij één stap.

    301 of 302?

    Gebruik 301 (of 308) voor permanente verhuizingen. 302 en 307 betekenen tijdelijk; Google kan de oude URL dan langer geïndexeerd houden.

    Hoe lang moet ik redirects na een migratie laten staan?

    Google adviseert minimaal een jaar; langer kost niets en behoudt de waarde van oude links.

    Maken redirects mijn site langzamer?

    Elke stap kost een extra rondreis voor bezoekers en crawlers. Eén stap is prima; ketens van drie of meer zijn het platslaan waard.

    iP
    IndexUrePoint is een onafhankelijke gids over hoe je je pagina’s gevonden en geïndexeerd krijgt — Google, Bing en AI-zoeken. We testen tools zelf en zeggen het eerlijk wanneer iets niet werkt. Fout gespot? Laat het ons weten via de contactpagina; we verbeteren het en vermelden de datum.

  • Sitemap kan niet worden gelezen of opgehaald: zo los je het op

    Sitemap kan niet worden gelezen of opgehaald: zo los je het op

    Read this guide in English →

    Google Search Console · Sitemaps

    “Sitemap kan niet worden gelezen” of “Kan niet worden opgehaald” betekent dat Google je sitemap probeerde te laden en dat dat mislukte — verkeerde URL, een blokkade, kapotte XML, of gewoon een verse indiening die nog verwerkt wordt.

    Belangrijkste punten
    • Eerste check: open de sitemap-URL zelf in een privévenster. Laadt hij netjes → meestal wachten; faalt hij → URL, blokkade of XML repareren.
    • De klassieke fout: /sitemap.xml indienen terwijl je plugin /sitemap_index.xml serveert.
    • Bij gloednieuwe sites springt “Kan niet worden opgehaald” vaak vanzelf binnen dagen op “Succesvol” — bij ons binnen minuten.
    • Limieten: 50.000 URL’s of 50 MB per sitemap; daarboven splitsen met een sitemapindex.
    • Een sitemap is een vindhulp, geen indexeerknop: goed gelinkte pagina’s worden ook zónder gevonden.
    Hoe dit is gecontroleerd. Geschreven op basis van Google’s sitemapdocumentatie en de hulp bij het Sitemaps-rapport.
    Kort antwoord

    Als Search Console zegt dat je sitemap niet kan worden gelezen of opgehaald, probeerde Google hem te laden en lukte dat niet: een fout, een blokkade of een bestand dat niet te lezen is.

    Open eerst zelf de sitemap-URL in je browser. Laadt hij als nette lijst, dan ligt het meestal aan Google’s kant of is een nieuwe inzending nog in behandeling — geef het een paar dagen. Laadt hij niet, los dan de URL, blokkade of XML-fout hieronder op.

    De check van 2 minuten

    Plak je exacte sitemap-URL in een privévenster van je browser.
    Hij laadt als lijst met URL’s
    1. Is het precies de URL die je indiende?
    2. Test hem met URL-inspectie → Live URL testen.
    3. Net ingediend? Wacht een paar dagen en dien één keer opnieuw in.
    Foutmelding, doorverwijzing of HTML
    1. 404? Verkeerde URL ingediend.
    2. Inlog-, firewall- of controlepagina? Googlebot wordt geblokkeerd.
    3. Rommel of leeg scherm? De XML is kapot.

    Wat je in de browser ziet Waarschijnlijke oorzaak Oplossing
    404 Verkeerde sitemap-URL ingediend De URL indienen die je plugin maakt
    Login- of controlepagina Firewall/botbescherming blokkeert Googlebot Geverifieerde zoekbots doorlaten
    Leeg of rommelig scherm Kapotte XML of cacheplugin XML valideren; sitemap uit de cache
    Laadt perfect Verse indiening of vertraging bij Google Paar dagen wachten, één keer opnieuw

    De echte oorzaken

    • Verkeerde URL. Yoast en Rank Math gebruiken /sitemap_index.xml; WordPress zonder SEO-plugin /wp-sitemap.xml. Uit gewoonte /sitemap.xml indienen is de klassieke fout.
    • Geblokkeerd voor Googlebot door robots.txt, een beveiligingsplugin, firewall of botbescherming.
    • Kapotte XML: lege regels of PHP-waarschuwingen vóór <?xml, of een cacheplugin die een geminificeerde HTML-versie serveert.
    • Te groot. Eén sitemap mag maximaal 50.000 URL’s of 50 MB (ongecomprimeerd) bevatten.
    • Serverfouten of time-outs op het moment dat Google hem ophaalde.
    • Net ingediend. Bij nieuwe sites toont het rapport vaak een tijd “Kan niet worden opgehaald”, ook als het bestand prima is.

    Oplossingen die werken

    • Dien de exacte URL in die je plugin maakt en verwijder oude inzendingen.
    • Sluit sitemaps uit van cache en minificatie en laat Googlebot door in je beveiligingsinstellingen.
    • Valideer de XML met een online sitemap-validator.
    • Zet de sitemap in robots.txt met een Sitemap:-regel, zodat ook Bing hem vindt.
    • Dien na het oplossen één keer opnieuw in. Vaker helpt niet.
    Onze mening
    Een sitemap helpt bij ontdekken; het is geen indexeringsknop. Goed intern gelinkte pagina’s worden ook gevonden als de sitemap even hapert. Worden pagina’s wel gevonden maar niet geïndexeerd, lees dan Gecrawld vs. Gevonden.

    Veelgestelde vragen

    Waarom zegt Search Console “Kan niet worden opgehaald” terwijl mijn sitemap werkt?

    Bij nieuwe inzendingen verschijnt deze status vaak tijdelijk. Laadt het bestand voor gewone bezoekers en slaagt een live test, wacht dan een paar dagen. Blijft het, controleer dan firewall- of botbeschermingsregels.

    Houdt een sitemapfout mijn site uit Google?

    Nee. Google vindt pagina’s ook via links. Een werkende sitemap helpt vooral bij nieuwe of grote sites.

    Hoeveel URL’s mag een sitemap bevatten?

    Maximaal 50.000 URL’s of 50 MB ongecomprimeerd. Daarboven splits je hem en dien je een sitemapindex in.

    Moet ik mijn sitemap ook bij Bing indienen?

    Ja, via Bing Webmaster Tools, en zet de Sitemap-regel in robots.txt. Voor directe updates in Bing gebruik je ook IndexNow.

    Hoort mijn sitemap in robots.txt te staan?

    Ja, met een Sitemap:-regel en de volledige URL. Alle grote crawlers, ook Bing, lezen hem daar zelfs zonder handmatige indiening.

    Kan ik meerdere sitemaps indienen?

    Ja: meerdere losse sitemaps of één sitemapindex die ze allemaal aanwijst. Search Console toont per sitemap een eigen status.

    iP
    IndexUrePoint is een onafhankelijke gids over hoe je je pagina’s gevonden en geïndexeerd krijgt — Google, Bing en AI-zoeken. We testen tools zelf en zeggen het eerlijk wanneer iets niet werkt. Fout gespot? Laat het ons weten via de contactpagina; we verbeteren het en vermelden de datum.

  • Soft 404-fout: wat het is en hoe je het oplost

    Soft 404-fout: wat het is en hoe je het oplost

    Read this guide in English →

    Google Search Console · Pagina-indexering

    Een soft 404 is een pagina die de browser “200 OK” meldt maar er voor Google leeg of verdwenen uitziet — dus behandelt Google hem als niet gevonden en blijft hij uit de index.

    Belangrijkste punten
    • De statuscode zegt “pagina bestaat”, de inhoud zegt “hier is niets” — Google gelooft de inhoud.
    • Zes vaste oorzaken: nep-404’s met code 200, lege archieven, uitgeklede productpagina’s, irrelevante redirects, placeholders en mislukte JavaScript-rendering.
    • Verwijderde pagina’s massaal naar de homepage sturen wordt zélf als soft 404 behandeld.
    • De oplossing volgt het paginatype: weg → echte 404/410; verhuisd → 301 naar het equivalent; echt → echte inhoud.
    • Bij JavaScript-sites: test de live URL in Search Console; een lege schermafbeelding betekent dat Google niets ziet.
    Hoe dit is gecontroleerd. Geschreven op basis van Google’s documentatie over soft 404-fouten en het rapport Pagina-indexering.
    Kort antwoord

    Een soft 404 is een pagina die de browser vertelt dat alles in orde is (HTTP 200), maar er voor Google uitziet als een ontbrekende of lege pagina. Google behandelt hem als “niet gevonden” en indexeert hem niet.

    De oplossing hangt af van wat de pagina écht is: weg? geef een echte 404 of 410. Verhuisd? 301 naar de meest vergelijkbare pagina. Echte pagina? geef hem genoeg echte inhoud.

    Wat een soft 404 is

    SERVER ZEGT

    200 OK — pagina bestaat

    Signaal: “Indexeer me, ik ben een normale pagina.”

    GOOGLE ZIET

    Leeg of “niet gevonden”

    Oordeel: de statuscode klopt niet, dus Google behandelt hem als 404.

    Wat de pagina echt is Juiste reactie Foute reactie
    Definitief weg 404 of 410 + uit de sitemap Redirect naar de homepage
    Vervangen door een andere pagina 301 naar het beste equivalent 301 naar iets willekeurigs
    Tijdelijk uitverkocht Live houden met volledige info Uitkleden tot één regel
    Echte pagina die leeg lijkt Rendering repareren / inhoud toevoegen Steeds opnieuw indexering aanvragen

    De zes gebruikelijke oorzaken

    • Eigen “niet gevonden”-pagina’s die 200 teruggeven in plaats van 404.
    • Lege categorie-, tag- of zoekpagina’s met alleen “Geen producten gevonden”.
    • Uitverkochte of verlopen items die zijn teruggebracht tot een titel en “niet meer leverbaar”.
    • Doorverwijzen naar een irrelevante pagina, vooral massaal verwijderde URL’s naar de homepage sturen.
    • Dunne placeholderpagina’s: “binnenkort beschikbaar”, bijna lege templates.
    • Weergaveproblemen. JavaScript dat voor Googlebot faalt, waardoor Google een lege pagina ziet.

    Oplossen per paginatype

    • Pagina bestaat niet meer? Geef een 404 of 410 en haal hem uit je sitemap en interne links.
    • Vervangen? 301 naar de meest vergelijkbare pagina — niet naar de homepage.
    • Webshop: houd tijdelijk uitverkochte producten online met volledige informatie, alternatieven en een verwachte leverdatum.
    • JavaScript-site: gebruik URL-inspectie → Live URL testen → Geteste pagina bekijken. Is de schermafbeelding leeg, los dan eerst de weergave op.
    • WordPress: controleer dat je 404-template echt een 404-status geeft, en zet lege tagarchieven op noindex.
    Onze mening
    Soft 404’s op pagina’s die toch weg horen zijn onschuldig. De pagina’s om op te lossen zijn échte pagina’s die Google voor leeg aanzag — en dat is bijna altijd een inhouds- of weergaveprobleem.

    Een uitgewerkt voorbeeld

    Een webshop haalt vijftig uitverkochte producten offline en stuurt alle oude URL’s naar de homepage. Twee weken later staan ze in Search Console als soft 404: de redirect zegt “verhuisd”, maar de homepage is geen vervanger voor een specifiek product. De juiste route was per product kiezen: is er een opvolger, stuur dan daarheen met een 301; is er alleen een passende categorie, stuur daarheen; is er niets vergelijkbaars, geef dan een echte 404 of 410 en haal de URL uit de sitemap. Na die correctie verdwijnen de meldingen vanzelf bij de volgende crawlronde — soft 404’s op bewust verwijderde pagina’s die netjes 404 geven, zijn daarna geen probleem meer.

    Veelgestelde vragen

    Is een soft 404 slecht voor SEO?

    Voor pagina’s die weg horen is het onschuldig maar slordig; een echte 404 of 410 is netter. Voor echte pagina’s is het wel slecht: Google indexeert ze pas als ze niet meer leeg lijken.

    Moet ik alle 404’s doorsturen naar de homepage?

    Nee. Google behandelt irrelevante doorverwijzingen naar de homepage meestal als soft 404. Verwijs alleen door naar een echt vergelijkbare pagina.

    Wat is het verschil tussen 404 en 410?

    Beide zeggen dat de pagina er niet is. 410 betekent “bewust en permanent weg”. In de praktijk behandelt Google beide als niet gevonden.

    Hoe laat ik Google opnieuw controleren?

    Los de pagina’s op en klik bij de melding op “Oplossing valideren”. Google crawlt de URL’s opnieuw; dat duurt meestal tot ongeveer twee weken.

    Waarom meldt Google een soft 404 op een bestaande pagina?

    Omdat de gerenderde pagina er voor Google leeg of als foutmelding uitziet: nauwelijks inhoud, een “niets gevonden”-tekst, of JavaScript dat voor Googlebot faalt.

    Verspillen soft 404’s crawlbudget?

    Ja, Googlebot blijft URL’s controleren die beweren te bestaan. Een echte 404 of 410 vertelt hem te stoppen.

    iP
    IndexUrePoint is een onafhankelijke gids over hoe je je pagina’s gevonden en geïndexeerd krijgt — Google, Bing en AI-zoeken. We testen tools zelf en zeggen het eerlijk wanneer iets niet werkt. Fout gespot? Laat het ons weten via de contactpagina; we verbeteren het en vermelden de datum.

  • Geblokkeerd door robots.txt (en “Geïndexeerd, maar geblokkeerd”): wat nu?

    Geblokkeerd door robots.txt (en “Geïndexeerd, maar geblokkeerd”): wat nu?

    Read this guide in English →

    Google Search Console · robots.txt

    “URL geblokkeerd door robots.txt” betekent dat je robots.txt Googlebot verbiedt de pagina te crawlen — en omdat robots.txt cràwlen regelt en niet indexeren, kan een geblokkeerde URL alsnog kaal in Google belanden.

    Belangrijkste punten
    • robots.txt stopt het crawlen; noindex stopt het indexeren. Die twee verwarren is dé klassieke robots-fout.
    • “Geïndexeerd, maar geblokkeerd door robots.txt” ontstaat als links wijzen naar een URL die Google niet mag lezen.
    • Wil je een pagina uit Google, dan moet je het crawlen juist toestaan zodat Google de noindex kan zien.
    • Veelgemaakte ongelukken: een achtergebleven Disallow: / van een testsite of een te brede voorvoegselregel.
    • Regels werken op het begin van het pad: Disallow: /blog blokkeert ook /blog-tips/.
    Hoe dit is gecontroleerd. Geschreven op basis van Google’s robots.txt-documentatie, de hulp bij het rapport Pagina-indexering en het robots.txt-rapport in Search Console.
    Kort antwoord

    “URL geblokkeerd door robots.txt” betekent dat je robots.txt Googlebot verbiedt deze URL te crawlen. Google kan de pagina dus niet lezen en indexeert de inhoud niet.

    “Geïndexeerd, maar geblokkeerd door robots.txt” is de vreemde tweeling: Google nam de URL toch op, meestal omdat andere pagina’s ernaar linken, zonder hem te kunnen lezen.

    De kernregel: robots.txt regelt crawlen, niet indexeren. Wil je een pagina uit Google houden, gebruik dan noindex — en laat Google de pagina crawlen zodat hij die tag kan zien.

    “URL geblokkeerd door robots.txt”

    Je robots.txt (op jouwsite.nl/robots.txt) bevat een Disallow-regel die op deze URL past. Voor beheerpagina’s, winkelwagens en interne zoekresultaten is dat precies de bedoeling. Voor artikelen en productpagina’s is het een fout.

    Veelvoorkomende ongelukjes: een achtergebleven Disallow: / van een testsite, een te brede regel zoals Disallow: /p die ook /producten/ raakt, of een plugin die het bestand herschreef.

    “Geïndexeerd, maar geblokkeerd door robots.txt”

    Google kan een URL indexeren die hij niet mag crawlen als er genoeg links naartoe wijzen. Hij toont dan de URL met weinig of geen beschrijving. Wat je doet hangt af van wat je wilt:

    JE WILT HEM IN GOOGLE

    Deblokkeren

    Oplossing: haal de Disallow-regel weg zodat Google kan crawlen en goed indexeren.

    JE WILT HEM WEG

    Deblokkeren + noindex

    Oplossing: sta crawlen toe en voeg noindex toe. Een geblokkeerde pagina kan zijn noindex niet laten zien.

    Doel robots.txt noindex Juiste keuze
    Pagina uit de zoekresultaten houden Onbetrouwbaar Ja Crawlen toestaan + noindex
    Crawlbudget sparen (filters, zoekpagina’s) Ja Geen effect op crawlen robots.txt Disallow
    Al geïndexeerde pagina verwijderen Maakt het erger Ja Deblokkeren + noindex, of 404/410
    AI-trainingsbots weren Ja (per user-agent) Nee robots.txt

    Beide statussen oplossen

    • Open het robots.txt-rapport in Search Console (Instellingen → robots.txt). Het toont welke versie Google ophaalde, wanneer, en eventuele fouten.
    • Zoek de regel die past. Regels werken op het begin van het pad: Disallow: /blog blokkeert ook /blog-tips/.
    • Pas voorzichtig aan. In WordPress kan dat via Yoast (Extra → Bestandseditor) of Rank Math. Blokkeer nooit CSS of JavaScript die je pagina’s nodig hebben.
    • Houd de sitemapregel erin: Sitemap: https://jouwsite.nl/sitemap_index.xml.
    • Valideer. Klik op “Oplossing valideren” of vraag indexering aan voor de belangrijkste pagina’s.
    Onze mening
    De grootste robots.txt-fout is het gebruiken om pagina’s te “verbergen”. Het verbergt niets — het maakt Google alleen blind. Gebruik robots.txt om crawlwerk te besparen en noindex om te bepalen wat in de zoekresultaten komt.

    Een uitgewerkt voorbeeld

    Een sitebeheerder wil interne zoekresultaten uit Google houden en zet Disallow: /?s= in robots.txt én een noindex op de zoekpagina’s. Klinkt dubbel veilig, maar het bijt elkaar: door de Disallow mag Google de pagina’s niet meer lezen en ziet hij de noindex dus nooit. URL’s met veel inkomende links kunnen dan als kale resultaten blijven staan — precies de melding “Geïndexeerd, maar geblokkeerd door robots.txt”. De juiste volgorde: eerst alleen de noindex laten staan tot de pagina’s uit de index zijn, en pàs daarna eventueel de Disallow toevoegen om crawlbudget te sparen. Andersom werkt het nooit.

    AI-crawlers: wil je GPTBot, ClaudeBot of Google-Extended apart toestaan of blokkeren, lees dan AI-crawlers en robots.txt — met voorbeeldregels per bot.

    Test je regels direct met onze gratis robots.txt-tester (Engels): je ziet welke regel een URL blokkeert voor Googlebot.

    Veelgestelde vragen

    Haalt robots.txt een pagina uit Google?

    Nee. robots.txt stopt alleen het crawlen. Een geblokkeerde URL kan via links toch geïndexeerd worden. Gebruik noindex, of verwijder de pagina en geef een 404 of 410.

    Moet ik AI-crawlers blokkeren in robots.txt?

    Dat kan, met regels voor hun eigen user-agents, maar het is een afweging: blokkeer je de crawler van een assistent, dan kom je niet in zijn antwoorden terecht.

    Hoe snel ziet Google wijzigingen in robots.txt?

    Google bewaart robots.txt doorgaans tot ongeveer een dag in de cache. Het robots.txt-rapport toont wanneer het laatst is opgehaald.

    Waar is de robots.txt-tester gebleven?

    Google heeft de oude tester vervangen door het robots.txt-rapport onder Instellingen in Search Console. URL-inspectie laat per URL zien of hij geblokkeerd is.

    Waar vind ik mijn robots.txt?

    Altijd in de root: jouwsite.nl/robots.txt. In WordPress kun je hem bewerken via Yoast (Extra → Bestandseditor) of Rank Math.

    Verbergt robots.txt een pagina voor bezoekers?

    Nee. Iedereen kan de URL gewoon openen en het robots.txt-bestand zelf is openbaar. Gebruik een login voor echt privémateriaal.

    iP
    IndexUrePoint is een onafhankelijke gids over hoe je je pagina’s gevonden en geïndexeerd krijgt — Google, Bing en AI-zoeken. We testen tools zelf en zeggen het eerlijk wanneer iets niet werkt. Fout gespot? Laat het ons weten via de contactpagina; we verbeteren het en vermelden de datum.

  • URL gemarkeerd als ‘noindex’: vinden, weghalen en toch geïndexeerd worden

    URL gemarkeerd als ‘noindex’: vinden, weghalen en toch geïndexeerd worden

    Read this guide in English →

    Google Search Console · noindex

    “URL gemarkeerd als noindex” betekent dat Google je pagina heeft gecrawld, een instructie vond om hem niet te indexeren en die heeft opgevolgd — de enige vraag is of jij die instructie bewust hebt geplaatst.

    Belangrijkste punten
    • Bewuste noindex (bedankpagina’s, archieven) vraagt geen actie; een per ongeluk genoindexte geldpagina is met één instelling gerepareerd.
    • Een noindex verstopt zich op vier plekken: de robots-metatag, de X-Robots-Tag-header, “Zoekmachines ontmoedigen” en je SEO-plugin.
    • Repareer de bron, niet de pagina: een berichttype op noindex zet elk nieuw bericht opnieuw op noindex.
    • De pagina moet crawlbaar blijven — blokkeer je hem in robots.txt, dan ziet Google nooit dat de noindex weg is.
    • Na de fix: cache legen en voor belangrijke pagina’s indexering aanvragen.
    Hoe dit is gecontroleerd. Geschreven op basis van Google’s documentatie over de noindex-richtlijn en het rapport Pagina-indexering, en getoetst aan hoe Yoast SEO, Rank Math en WordPress robots-metatags uitvoeren.
    Kort antwoord

    “URL gemarkeerd als ‘noindex’” betekent dat Google de pagina heeft gecrawld, een instructie vond om hem niet te indexeren, en die heeft opgevolgd.

    Is dat de bedoeling (bedankpagina’s, tagarchieven, privépagina’s), dan hoef je niets te doen. Is het een pagina die je wél in Google wilt, zoek dan waar de noindex vandaan komt — je SEO-plugin, een WordPress-instelling of een HTTP-header — haal hem weg en vraag indexering aan.

    Wat de melding betekent

    BEWUST

    Laten staan

    Voorbeelden: inlog-, winkelwagen- en bedankpagina’s, interne zoekresultaten, dunne archieven.

    PER ONGELUK

    Nu oplossen

    Voorbeelden: blogartikelen, productpagina’s, je homepage — alles wat verkeer moet opleveren.

    Waar een noindex zich verstopt

    • De robots-metatag in de HTML: <meta name=”robots” content=”noindex”>. Bekijk de paginabron en zoek op “noindex”.
    • De X-Robots-Tag-header, ingesteld door server, CDN of plugin. Onzichtbaar in de paginabron — URL-inspectie laat het zien bij “Indexeren toegestaan?”.
    • “Zoekmachines ontmoedigen” in WordPress (Instellingen → Lezen). Eén vinkje dat de hele site op noindex zet.
    • Instellingen van je SEO-plugin. Yoast: “Zoekmachines toestaan deze inhoud in zoekresultaten te tonen?” per bericht en per inhoudstype. Rank Math: de Robots Meta-instelling.
    • Onderhouds- of “binnenkort beschikbaar”-plugins die zolang ze actief zijn een noindex toevoegen.
    Waar de noindex zit Zo controleer je het Zo los je het op
    Robots-metatag in de HTML Paginabron, zoek “noindex” Per-bericht-instelling in je SEO-plugin
    X-Robots-Tag-header URL-inspectie → “Indexeren toegestaan?” Server-/CDN-/plugininstelling
    WordPress → Lezen Vinkje “Zoekmachines ontmoedigen” Vinkje uitzetten
    Standaard per berichttype SEO-plugin → Weergave in zoekresultaten Type op indexeerbaar zetten

    Stap voor stap weghalen

    • Bevestig het met URL-inspectie (live test). Daar zie je of de noindex in de metatag of in de header zit.
    • Los de bron op, niet alleen de pagina. Staat een heel berichttype op noindex, dan erft elk nieuw bericht dat.
    • Leeg je cache. Paginacache en CDN kunnen de oude HTML nog even serveren.
    • Zorg dat de pagina niet in robots.txt geblokkeerd is — Google moet hem kunnen crawlen om de wijziging te zien. Zie Geblokkeerd door robots.txt.
    • Vraag indexering aan voor belangrijke pagina’s en klik op “Oplossing valideren” voor de rest.
    Onze mening
    Een verdwaalde noindex is het goedkoopste indexeringsprobleem dat er is: één instelling, direct op te lossen. Daarom is het stap één in onze gids Website aanmelden bij Google.

    Een uitgewerkt voorbeeld

    Een bedrijf lanceert zijn nieuwe site en de weken erna komt er geen enkele pagina in Google. Paniek, backlinks gekocht, niets helpt. De echte oorzaak: tijdens de bouw stond “Zoekmachines ontmoedigen om deze site te indexeren” aan, en niemand zette het vinkje na de lancering uit. Eén instelling, weken verlies. Daarom is dit de eerste controle in elke indexeringsdiagnose: Instellingen → Lezen in WordPress, daarna URL-inspectie op de homepage. Staat daar “Indexeren toegestaan? Nee: ‘noindex’ gedetecteerd”, dan weet je binnen een minuut waar je moet zijn — en na het uitzetten en opnieuw aanvragen stonden in dit soort gevallen de eerste pagina’s er binnen dagen in.

    Veelgestelde vragen

    Hoe snel wordt de pagina geïndexeerd na het weghalen van noindex?

    Google moet de pagina eerst opnieuw crawlen. Met Indexering aanvragen gaat dat vaak binnen dagen; minder belangrijke pagina’s kunnen weken duren.

    Is noindex hetzelfde als blokkeren in robots.txt?

    Nee. noindex zegt “toon dit niet in zoekresultaten” en vereist dat de pagina gecrawld wordt. robots.txt zegt “crawl dit niet” en houdt een URL niet betrouwbaar uit de index.

    Moet ik tag- en categoriepagina’s op noindex zetten?

    Alleen als ze dun of dubbel zijn. Nuttige categoriepagina’s met een eigen introductie kunnen goed ranken.

    Geldt noindex ook voor Bing?

    Ja. Bing en andere grote zoekmachines respecteren de robots-metatag en de X-Robots-Tag-header op dezelfde manier.

    Is een noindex een straf van Google?

    Nee, het is een instructie die je eigen site meestuurt. Google gehoorzaamt simpelweg; haal hem weg en de pagina komt weer in aanmerking voor indexering.

    Moet ik noindex combineren met nofollow?

    Meestal niet: met alleen noindex blijven de links op de pagina signalen doorgeven. Parkeer belangrijke pagina’s niet langdurig op noindex.

    iP
    IndexUrePoint is een onafhankelijke gids over hoe je je pagina’s gevonden en geïndexeerd krijgt — Google, Bing en AI-zoeken. We testen tools zelf en zeggen het eerlijk wanneer iets niet werkt. Fout gespot? Laat het ons weten via de contactpagina; we verbeteren het en vermelden de datum.

  • Welke URL houdt Google? Canonieke meldingen in Search Console uitgelegd

    Welke URL houdt Google? Canonieke meldingen in Search Console uitgelegd

    Read this guide in English →

    Google Search Console · Canonieke URL’s

    Ziet Google meerdere vrijwel identieke URL’s, dan indexeert hij er precies één: de canonieke versie. De drie canonieke meldingen in Search Console vertellen alleen wie die keuze maakte — jij, Google, of allebei eens.

    Belangrijkste punten
    • “Dubbele pagina zonder door de gebruiker geselecteerde canonieke versie”: jij gaf geen voorkeur op, Google koos zelf.
    • “Duplicaat, Google heeft een andere canonieke pagina gekozen”: jij wees, Google negeerde je hint.
    • “Alternatieve pagina met correcte canonieke tag”: jij wees, Google was het eens — meestal goed nieuws.
    • De oplossing is altijd dezelfde: laat canonical, sitemap, interne links en redirects dezelfde URL noemen.
    • Taalversies koppel je met hreflang, niet met een canonical: elke taal is zijn eigen canonieke pagina.
    Hoe dit is gecontroleerd. Geschreven op basis van Google’s documentatie over canonieke URL’s en het rapport Pagina-indexering (inclusief de officiële Nederlandse statuslabels).
    Kort antwoord

    Als Google meerdere bijna-identieke URL’s ziet, kiest hij er één om te indexeren: de canonieke versie. De rest wordt als duplicaat opzijgezet.

    Search Console toont drie varianten: “Dubbele pagina zonder door de gebruiker geselecteerde canonieke versie” (jij gaf geen voorkeur op), “Duplicaat, Google heeft een andere canonieke pagina gekozen dan de gebruiker” (Google negeerde jouw voorkeur) en “Alternatieve pagina met correcte canonieke tag” (alles werkt zoals bedoeld).

    De oplossing is bijna altijd hetzelfde: laat al je signalen naar dezelfde URL wijzen.

    Wat “canoniek” betekent

    Google groepeert pagina’s met (vrijwel) dezelfde inhoud en indexeert er één. Jij kunt een voorkeur aangeven met een rel=”canonical”-tag, je sitemap, interne links en doorverwijzingen. Maar Google behandelt die tag als een hint, geen bevel. Spreken je signalen elkaar tegen, dan kiest Google zelf.

    De drie meldingen — en wat ze betekenen

    GEEN VOORKEUR

    Dubbele pagina zonder canonieke versie

    Betekenis: je gaf geen canonical op, dus Google koos zelf. Deze URL verloor.

    GOOGLE KIEST ANDERS

    Google koos een andere canonieke pagina

    Betekenis: je canonical wijst de ene kant op, Google koos de andere.

    De derde, “Alternatieve pagina met correcte canonieke tag”, is meestal goed nieuws: de pagina verwijst netjes naar een andere canonieke versie en Google is het ermee eens. Die kun je doorgaans negeren — tenzij er een unieke pagina tussen staat die je juist wél in Google wilt.

    Melding Wie koos? Actie
    Dubbele pagina zonder canonieke versie Google (jij zei niets) Zelfverwijzende canonicals toevoegen
    Google koos een andere canonieke pagina Google (tegen jouw hint in) Signalen gelijktrekken, URL versterken
    Alternatieve pagina met correcte tag Jij, met Google’s zegen Meestal niets

    Welke heb jij? Controle in 60 seconden

    Open de URL in URL-inspectie. Vergelijk “Door gebruiker opgegeven canonieke URL” met “Door Google geselecteerde canonieke URL”.
    Het is een ongewenste variant
    1. Parameter-, tracking- of filter-URL?
    2. Koos Google je echte pagina?
    3. Dan werkt het zoals bedoeld.
    Het is een pagina die je wilt laten ranken
    1. Is de inhoud echt uniek?
    2. Verwijst de canonical naar zichzelf?
    3. Linken sitemap en interne links naar deze URL?

    Oplossingen die werken (in deze volgorde)

    • Laat je signalen overeenkomen. Sitemap, canonical, interne links en doorverwijzingen moeten allemaal dezelfde URL noemen. Tegenstrijdige signalen zijn de nummer-één-oorzaak.
    • Geef elke belangrijke pagina een canonical naar zichzelf. Yoast SEO en Rank Math doen dit automatisch; controleer de paginabron op rel=”canonical”.
    • Ruim dubbele varianten op. http en https, www en zonder www, met en zonder slash aan het eind: stuur alles met een 301 door naar één versie.
    • Versterk de URL die je wilt. Link er intern naartoe vanaf sterke, al geïndexeerde pagina’s.
    • Voeg echte duplicaten samen. Twee bijna gelijke pagina’s? Maak er één sterke pagina van en verwijs de andere door.
    • Taalversies? Elke taalversie is zijn eigen canonieke pagina; koppel ze met hreflang, niet met een canonical.
    Onze mening
    Blijf niet op “Indexering aanvragen” drukken in de hoop dat Google van gedachten verandert. Dat gebeurt niet. Los de tegenstrijdige signalen op en geef Google één nieuwe crawlronde.

    Veelgestelde vragen

    Schaden deze meldingen mijn rankings?

    Niet direct: de inhoud rankt via de URL die Google koos. Het wordt pas een probleem als Google een zwakkere of verkeerde versie kiest, of als linkwaarde over duplicaten wordt verdeeld.

    Dwingt een canonical-tag Google om te gehoorzamen?

    Nee. Het is een sterke hint, geen opdracht. Als links, sitemap en doorverwijzingen iets anders zeggen, kan Google de tag negeren.

    Moet ik “Alternatieve pagina met correcte canonieke tag” oplossen?

    Meestal niet. Het bevestigt dat je canonicals werken. Alleen als er een unieke pagina tussen staat die je wilt laten ranken, klopt de canonical van die pagina niet.

    Hoe lang duurt het voordat Google zijn keuze aanpast?

    Na het rechttrekken van je signalen meestal dagen tot enkele weken, afhankelijk van hoe snel Google beide URL’s opnieuw crawlt.

    Kan ik zien welke canonieke URL Google koos?

    Ja. URL-inspectie in Search Console toont de door jou opgegeven én de door Google geselecteerde canonieke URL naast elkaar.

    Veroorzaken URL-parameters een duplicate-content-boete?

    Nee. Parameters maken dubbele URL’s, geen boetes. Google vouwt ze samen tot één canonieke versie; jouw taak is zorgen dat dat de juiste is.

    iP
    IndexUrePoint is een onafhankelijke gids over hoe je je pagina’s gevonden en geïndexeerd krijgt — Google, Bing en AI-zoeken. We testen tools zelf en zeggen het eerlijk wanneer iets niet werkt. Fout gespot? Laat het ons weten via de contactpagina; we verbeteren het en vermelden de datum.

  • Hoe lang duurt het voordat Google je pagina indexeert?

    Hoe lang duurt het voordat Google je pagina indexeert?

    Read this guide in English →

    Google Search Console · Indexeersnelheid

    Op een gevestigde, gezonde site wordt een nieuwe, intern gelinkte pagina meestal binnen enkele uren tot ongeveer een week geïndexeerd; op een gloednieuw domein reken je op dagen tot enkele weken — er is geen vaste timer, alleen vertrouwen, links en kwaliteit.

    Belangrijkste punten
    • Indexeren bestaat uit drie fasen — ontdekken, crawlen, indexeren — en de wachttijd kan in elke fase zitten.
    • Google’s eigen richtlijn: crawlen en indexeren kan “enkele dagen tot enkele weken” duren.
    • De betrouwbaarste versneller is een interne link vanaf een sterke, al geïndexeerde pagina.
    • “Indexering aanvragen” zet de URL één keer in de wachtrij; dagelijks herhalen verandert niets.
    • Maak je pas zorgen als een goed gelinkte, waardevolle pagina op een gevestigde site na 3–4 weken nog buiten staat.
    Hoe dit is gecontroleerd. Geschreven op basis van Google’s Search Central-richtlijnen over crawlen en indexeren. De termijnen zijn gangbare bandbreedtes, geen garanties.
    Kort antwoord

    Op een gevestigde, gezonde site wordt een nieuwe, intern gelinkte pagina meestal binnen enkele uren tot ongeveer een week geïndexeerd.

    Op een gloednieuw domein reken je op dagen tot enkele weken, soms langer, terwijl Google de site leert vertrouwen.

    Er is geen vaste timer. Google indexeert een pagina als hij hem heeft gecrawld en hem de moeite waard vindt.

    De drie fasen — en waar de tijd echt zit

    1 · ONTDEKKEN

    Google vindt de URL

    Wachttijd: uren tot dagen. Versnel met een sitemap en interne links.

    2 · CRAWLEN

    Googlebot haalt hem op

    Wachttijd: uren tot weken, afhankelijk van crawlbudget en prioriteit.

    De derde fase — indexeren — is waar Google beslist of de opgehaalde pagina het bewaren waard is. Een dunne of dubbele pagina kan snel gecrawld worden en toch nooit in de index komen.

    Gangbare termijnen

    • Gevestigde site, goed gelinkte pagina: enkele uren tot ~1 week.
    • Gevestigde site, diep of zwak gelinkte pagina: 1–4 weken.
    • Gloednieuw domein: dagen tot enkele weken voor de eerste pagina’s.
    • Dunne, dubbele of weinig waardevolle pagina: mogelijk nooit, hoe lang je ook wacht.
    De eerlijke kanttekening
    Wie een exact aantal dagen belooft, gokt. Google zegt zelf dat crawlen en indexeren enkele dagen tot enkele weken kan duren, sterk afhankelijk van de site.
    Situatie Gangbare termijn Belangrijkste knop
    Gevestigde site, goed gelinkte pagina Uren tot ~1 week Doorgaan met wat werkt
    Gevestigde site, diepe/zwak gelinkte pagina 1–4 weken Interne links, klikdiepte
    Gloednieuw domein Dagen tot enkele weken Publiceren + links verdienen, geduld
    Dunne of dubbele pagina Mogelijk nooit Inhoud verbeteren of samenvoegen

    Sneller geïndexeerd worden: de knoppen die echt werken

    • Link de nieuwe pagina intern vanaf sterke, al geïndexeerde pagina’s. De betrouwbaarste versneller.
    • Zet hem in je sitemap en zorg dat die is ingediend in Search Console.
    • Gebruik URL-inspectie → Indexering aanvragen één keer, voor een pagina die echt klaar is.
    • Voor Bing: gebruik IndexNow. (Google doet daar niet aan mee.)
    • Maak de pagina het bewaren waard. Snelheid volgt kwaliteit.

    Wanneer je je echt zorgen moet maken

    Maak je zorgen als een goed gelinkte, waardevolle pagina op een gevestigde site na 3–4 weken nog niet is geïndexeerd. Kijk dan naar de status in Search Console: staat er Gevonden, dan is het een prioriteitsprobleem; staat er Gecrawld – momenteel niet geïndexeerd, dan is het een waardeprobleem. Beide leggen we uit in Gecrawld vs. Gevonden.

    Veelgestelde vragen

    Maakt “Indexering aanvragen” het direct?

    Nee. Het zet de URL hoger in de crawlwachtrij, maar Google beslist zelf wanneer hij crawlt en of hij indexeert. Voor een goede pagina helpt het vaak binnen uren tot dagen.

    Waarom duurt het bij mijn nieuwe site zo lang?

    Nieuwe domeinen hebben weinig vertrouwen en links, dus Google crawlt voorzichtig. Blijf nuttige pagina’s publiceren en links verdienen; de snelheid verbetert vanzelf.

    Mijn pagina was geïndexeerd en is weer verdwenen. Waarom?

    Google herbeoordeelt pagina’s. Een pagina kan vallen als hij dun, dubbel of minder waardevol wordt gevonden. Verbeter hem en laat Google opnieuw crawlen.

    Helpt vaker publiceren?

    Indirect. Een site die regelmatig nuttige inhoud publiceert, wordt vaak vaker gecrawld — maar frequentie zonder kwaliteit helpt niet.

    Indexeert Google sneller op bepaalde tijdstippen?

    Daar is geen serieus bewijs voor. Crawlfrequentie volgt vertrouwen, gezondheid en publicatieritme van je site, niet de klok of de dag van de week.

    Versnellen social-media-shares het indexeren?

    Hooguit indirect: de meeste sociale links zijn nofollow. De betrouwbare route blijft interne links, een sitemap en voor Bing IndexNow.

    iP
    IndexUrePoint is een onafhankelijke gids over hoe je je pagina’s gevonden en geïndexeerd krijgt — Google, Bing en AI-zoeken. We testen tools zelf en zeggen het eerlijk wanneer iets niet werkt. Fout gespot? Laat het ons weten via de contactpagina; we verbeteren het en vermelden de datum.