Category: Nederlands

Onze gidsen over indexering in Google, Bing en AI-zoeken, in het Nederlands.

  • Indexeringsrapport in Search Console mist data: wat er gebeurd is en wat je eraan doet

    Indexeringsrapport in Search Console mist data: wat er gebeurd is en wat je eraan doet

    Nieuws · Search Console · 30 september 2026

    Mist er in het indexeringsrapport van Search Console een stuk van juni 2026, dan is er niets mis met je site en komen die gegevens niet terug. Google zegt indexeringsdata niet achteraf aan te vullen. Mijn mening: gebruik dat rapport niet als enige bron voor wat er geïndexeerd is, en hou zelf een logboek bij.

    Belangrijkste punten
    • In juni 2026 stopte het indexeringsrapport met bijwerken: het bleef bijna drie weken op de gegevens van 11 juni staan en liep op 3 juli bij, met data tot en met 29 juni (ALM Corp, naar Search Engine Land).
    • Op 11 september merkten site-eigenaren dat een deel van de juni-data was verdwenen. John Mueller van Google zei dat er simpelweg geen data bestaat voor de periode waarin het rapport vertraagd was (Search Engine Roundtable).
    • Het gat zit in het rapport, niet in de index van Google. Je pagina’s zijn niet verwijderd omdat de grafiek een lege of vlakke periode heeft.
    • De oplossing ligt bij jezelf: exporteer het rapport regelmatig en hou een eenvoudig overzicht bij van welke URL’s geïndexeerd zijn.

    Wat is er met het indexeringsrapport gebeurd?

    Het rapport Pagina-indexering gebruiken de meeste mensen om te zien welke URL’s Google heeft geïndexeerd en waarom andere zijn overgeslagen. In juni 2026 bleef het stilstaan. Volgens de berichtgeving van Search Engine Land, samengevat door ALM Corp, stond het rapport ongeveer drie weken op de gegevens van 11 juni. Op de ochtend van 3 juli werd het bijgewerkt, met cijfers tot 29 juni. Een openbare verklaring van Google over de oorzaak was er toen niet.

    Wie in die periode een indexeringsprobleem aan het oplossen was, had pech: je kon een noindex-tag weghalen, een redirect repareren of een sitemap opnieuw indienen, en het rapport kon niet laten zien of het werkte.

    Het tweede deel volgde op 11 september. Site-eigenaren, onder wie Dan Lauer op Bluesky, zagen dat een stuk juni-data dat uren eerder nog zichtbaar was, weg was. Barry Schwartz meldde het op Search Engine Roundtable. John Mueller antwoordde dat het gat waarschijnlijk komt van de periode in juni waarin de data vertraagd was: het rapport werd toen niet bijgewerkt, dus er valt niets te tonen. Google’s standpunt, in zijn woorden: “We don’t back-fill indexing data.”

    ~3 wekenstond het rapport op de data van 11 juni voordat het op 3 juli werd bijgewerkt — ALM Corp
    29 junilaatste datum die zichtbaar was toen het rapport op 3 juli bijliep
    0achteraf aangevulde dagen: Google vult indexeringsdata niet aan — Search Engine Roundtable

    Betekent een gat in het rapport dat mijn pagina’s uit de index zijn?

    Nee. Een ontbrekende periode in de grafiek zegt dat Google voor die dagen geen rapportdata heeft vastgelegd. Het zegt niet dat pagina’s uit de index zijn gehaald. Het zijn twee verschillende systemen: de index levert zoekresultaten, het rapport is een verslaglaag daaroverheen.

    Schadelijk is vooral de verwarring. Vergelijk je het huidige aantal geïndexeerde pagina’s met een junicijfer dat niet meer bestaat, dan denk je misschien pagina’s kwijt te zijn die je nooit kwijt was. Vergelijk alleen met data die er wel is, en controleer belangrijke pagina’s met de URL-inspectietool (Engelstalige uitleg).

    Hoe hou ik zelf bij welke pagina’s geïndexeerd zijn?

    De les van juni is simpel: een rapport dat je niet zelf beheert kan te laat, bevroren of onvolledig zijn. Een klein logboek kost tien minuten per maand.

    • Exporteer het rapport periodiek. Het rapport Pagina-indexering heeft een exportfunctie. Sla de lijsten met geïndexeerde en niet-geïndexeerde pagina’s maandelijks op, met de datum in de bestandsnaam, of na elke grote wijziging.
    • Hou een lijst bij van de URL’s die ertoe doen. Nieuwe artikelen, belangrijke pagina’s en alles wat je hebt gerepareerd. Noteer per URL de publicatiedatum, de datum van je indexeringsverzoek en de status die je zag.
    • Inspecteer belangrijke URL’s rechtstreeks. De URL-inspectie toont de laatste crawldatum en of de pagina op Google staat, los van de grafiek.
    • Lees je serverlogs. Googlebot-verzoeken in de logs van je hosting laten zien wanneer een pagina echt is opgehaald, wat Search Console ook toont.
    • Voeg een tweede zoekmachine toe. Bing Webmaster Tools geeft je een apart beeld van wat gevonden en geïndexeerd is, en ondersteunt IndexNow.

    Hoeveel kun je nu op indexeringsrapporten vertrouwen?

    Vertrouw ze voor de richting, niet voor het cijfer van één dag. Search Console had eerder dit jaar rapportagevertragingen en begin september nog een rapportagestoring, dus een dip van een dag of een vlakke week is zwak bewijs. Sterker bewijs is een geleidelijke verandering over meerdere weken, of iets wat je met een directe URL-inspectie bevestigt.

    Dat geldt ook na de spamupdate van september 2026 (Engelstalig artikel). Wil je weten of die update pagina’s naar “Gecrawld – momenteel niet geïndexeerd” heeft geduwd, dan heb je een schone voor-en-nameting nodig. Je eigen export van vóór 24 september is meer waard dan een grafiek met gaten. Blijven pagina’s hangen, begin dan bij gecrawld versus ontdekt en hoe lang het duurt voordat Google je pagina indexeert.

    Onze mening
    Het rapport is handig, maar geen garantie. Wie zelf een maandelijkse export en een korte lijst met belangrijke URL’s bewaart, kan de vraag “was deze pagina in juni geïndexeerd?” beantwoorden zonder hulp van Google. Wie alleen op de grafiek vertrouwt, kan dat niet, en dat gat blijft nu permanent.

    Veelgestelde vragen

    Waarom ontbreekt juni 2026 in mijn indexeringsrapport in Search Console?

    Het rapport was in juni 2026 vertraagd en Google zegt indexeringsdata niet achteraf aan te vullen, dus er is geen data voor de periode waarin het niet werd bijgewerkt.

    Komen de ontbrekende indexeringsgegevens in Search Console terug?

    Niet volgens Google. John Mueller zei dat het rapport Pagina-indexering in de vertraagde periode niet is bijgewerkt en dat Google indexeringsdata niet achteraf aanvult.

    Betekent ontbrekende indexeringsdata dat mijn pagina’s uit Google zijn verwijderd?

    Nee. Het gat zit in het rapport, niet in de index. Gebruik de URL-inspectietool om te controleren of een specifieke pagina op Google staat.

    Hoe kan ik bijhouden welke pagina’s geïndexeerd zijn?

    Exporteer het rapport Pagina-indexering regelmatig, hou een gedateerde lijst bij van je belangrijke URL’s met hun status, inspecteer belangrijke pagina’s met de URL-inspectie en bekijk Googlebot-verzoeken in je serverlogs.

    Wanneer werd het indexeringsrapport na de vertraging in juni hersteld?

    Het werd op de ochtend van 3 juli 2026 bijgewerkt en toonde data tot en met 29 juni, nadat het ongeveer drie weken op de gegevens van 11 juni had gestaan.

    B
    Ben runt IndexUrePoint en beheert meerdere websites in Google Search Console en Bing Webmaster Tools, waaronder deze. Fout gezien? Laat het weten via de contactpagina; we passen het aan en vermelden de datum. Dit artikel is ook beschikbaar in het Engels.

  • Afbeeldingsmetadata en SEO: zo krijg je credit voor je afbeeldingen in Google

    Afbeeldingsmetadata en SEO: zo krijg je credit voor je afbeeldingen in Google

    Afbeeldingen-SEO · Google Afbeeldingen · gids 2026

    Google leest wie een afbeelding maakte, wie je moet vermelden en waar de licentie staat op twee plekken: IPTC-fotometadata in het bestand zelf en ImageObject-structured data op de pagina. Voeg je een licentie-URL toe, dan komen je afbeeldingen in aanmerking voor het label Licentie (Licensable) in Google Afbeeldingen. Wij deden dit bij alle afbeeldingen op deze site, en ontdekten dat je hosting de helft ervan ongemerkt kan weghalen.

    Belangrijkste punten
    • Google haalt zes IPTC-velden uit een afbeelding: Creator, Credit Line, Copyright Notice, Web Statement of Rights, Licensor URL en Digital Source Type (Google).
    • Voor het licentielabel heb je een Web Statement of Rights (IPTC) of de eigenschap license (structured data) nodig. Spreken ze elkaar tegen, dan wint de structured data.
    • Metadata vervangt de alt-tekst niet: Google gebruikt nog steeds alt-tekst, bestandsnaam en de tekst rond de afbeelding om te begrijpen wat erop staat.
    • Op onze Hostinger-site zette het CDN elke afbeelding opnieuw om en bleven alleen de rechtenvelden staan: omschrijving, trefwoorden en het AI-label verdwenen.
    • Drie dagen na livegang toonde Search Console 8 geldige en 0 ongeldige items onder Metadata van afbeelding.
    Hoe dit is gecontroleerd. Uit eigen ervaring: op 26 september 2026 hebben we alle 42 artikelafbeeldingen van indexurepoint.com opnieuw opgebouwd, met zichtbare branding, IPTC/XMP/EXIF-metadata en licentieschema. Daarna hebben we de live bestanden als JPEG en WebP gedownload en uitgelezen met ExifTool. De cijfers uit Search Console zijn op 29 september 2026 afgelezen. De regels komen uit Googles documentatie over afbeeldingsmetadata in Google Afbeeldingen en best practices voor afbeeldingen.

    Welke afbeeldingsmetadata leest Google?

    Google gebruikt afbeeldingsmetadata om in Google Afbeeldingen te tonen wie achter een afbeelding zit en hoe je hem mag gebruiken. Die informatie kan uit het bestand zelf komen (IPTC-fotometadata, opgeslagen als IPTC of XMP) of uit structured data op de pagina. Dit zijn de velden die tellen:

    Wat het zegt IPTC-veld (in het bestand) Structured data (op de pagina)
    Wie het maakte Creator creator
    Wie je vermeldt Credit Line creditText
    Wie het copyright heeft Copyright Notice copyrightNotice
    Waar de licentie staat Web Statement of Rights license
    Waar je een licentie krijgt Licensor URL acquireLicensePage
    Of er AI bij kwam kijken Digital Source Type —

    Bij structured data is alleen contentUrl verplicht, plus minstens één van creator, creditText, copyrightNotice of license. Google koppelt de metadata via contentUrl aan de juiste afbeelding, dus dat moet de echte URL van het afbeeldingsbestand zijn.

    Hoe krijg je het licentielabel in Google Afbeeldingen?

    Het licentielabel in Google Afbeeldingen linkt naar je licentie en laat zien hoe iemand de afbeelding mag gebruiken. Googles regel is kort: met IPTC moet je de Web Statement of Rights invullen, met structured data moet je license opnemen. Beide wijzen naar een pagina met de voorwaarden.

    Dat hoeft geen betaalde licentiewinkel te zijn. Op onze pagina Image use & credit staat dat je onze afbeeldingen gratis mag delen, met een bronvermelding en een link naar het artikel. Ook dat is een licentie, en zo wordt elke gekopieerde afbeelding een mogelijke backlink.

    Tip
    Google vraagt je de metadata toe te voegen op elke plek waar een afbeelding staat, ook als het dezelfde afbeelding is op meerdere pagina’s. In WordPress gaat dat automatisch als je het via een filter op het schema van de hele site toevoegt, zoals wij deden.

    IPTC of structured data: wat gebruik je?

    Allebei, als dat kan. Ze doen elk iets anders:

    • Structured data vertrouwt Google het meest. De documentatie zegt dat Google bij tegenstrijdige informatie de structured data gebruikt. Het staat bovendien op je eigen pagina, dus niemand kan het weghalen.
    • IPTC-metadata reist mee met het bestand. Downloadt iemand je afbeelding en plaatst hij die ergens anders, dan kunnen maker en licentie-URL meegaan, tenzij onderweg iets ze weghaalt.

    In WordPress met Yoast SEO staat de hoofdafbeelding van een artikel al als ImageObject in het schema. Wij hebben daar creator, creditText, copyrightNotice, license en acquireLicensePage aan toegevoegd met een klein filter op het schema van Yoast. Zo krijgt elke bestaande en toekomstige afbeelding dezelfde velden.

    Wat er gebeurde bij onze 42 afbeeldingen

    Op 26 september 2026 hebben we de hoofdafbeelding van elk artikel op deze site opnieuw gemaakt: met een zichtbare balk met de URL van het artikel, de auteur en het jaar, en met metadata die we met ExifTool in IPTC, XMP en EXIF schreven. Daarna hebben we de live bestanden gedownload zoals een browser ze krijgt. Onze hosting levert afbeeldingen via een CDN dat ze opnieuw omzet, vaak naar WebP, en die omzetting bepaalde wat er overbleef.

    Veld dat we schreven Nog in het live bestand?
    Maker (XMP + IPTC By-line) Ja
    Copyright-/rechtentekst (met artikel-URL) Ja
    Web Statement of Rights (licentie-URL) Ja
    IPTC Credit Line en Copyright Notice Ja, in de JPEG
    EXIF Artist en Copyright Ja, ook in de WebP
    Omschrijving, kop, trefwoorden Nee
    Licensor URL Nee
    Digital Source Type (AI-label) Nee

    De optimalisatie liet dus precies de rechteninformatie staan en gooide de rest weg. Voor de bronvermelding is dat genoeg, maar je kunt voor omschrijving en trefwoorden niet op het bestand vertrouwen. Die horen in de alt-tekst, het bijschrift en op de pagina zelf.

    Nog twee kleinere lessen. Het ©-teken raakte verminkt in de IPTC Copyright Notice na de omzetting. Daarom schrijven we daar nu “Copyright 2026 IndexUrePoint” en gebruiken we het © alleen in XMP. En IPTC-velden hebben harde lengtegrenzen: Credit Line en Source mogen maar 32 tekens bevatten, dus “IndexUrePoint.com” past wel en een volledige URL niet.

    84nieuwe afbeeldingen op indexurepoint.com: 42 artikelafbeeldingen (1600×900) en 42 deelafbeeldingen (1200×630)
    5 van 8groepen metadata die de omzetting door de hosting overleefden, allemaal over rechten
    8 / 0geldige / ongeldige items in het Search Console-rapport Metadata van afbeelding op 29 sept 2026, drie dagen later

    Hoe controleer je je eigen afbeeldingen?

    Vertrouw niet op het bestand op je eigen computer; controleer het bestand dat bezoekers en Googlebot krijgen. Met ExifTool geïnstalleerd:

    curl -s -o live.jpg https://example.com/wp-content/uploads/image.jpg
    curl -s -o live.webp -H "Accept: image/webp" https://example.com/wp-content/uploads/image.jpg
    exiftool -G1 -s -Creator -Rights -WebStatement -Credit -CopyrightNotice live.jpg live.webp

    De tweede regel vraagt om WebP, zoals Chrome dat doet. Juist daar verdwijnt metadata vaak. Daarna:

    • Test de pagina in Googles test voor rich results om te zien of het ImageObject een license en contentUrl heeft.
    • Kijk in Search Console onder Optimalisaties naar het rapport Metadata van afbeelding. Bij ons verscheen het binnen enkele dagen nadat we de metadata hadden toegevoegd. Je pagina’s moeten wel eerst gecrawld zijn, dus meld je site aan bij Google als dat nog niet is gebeurd.

    En AI-afbeeldingen?

    Google leest het IPTC-veld Digital Source Type en ondersteunt vier waarden voor AI, waaronder trainedAlgorithmicMedia (gemaakt door een generatief model) en compositeWithTrainedAlgorithmicMedia (een samengestelde afbeelding met AI-materiaal). De basis van onze illustraties komt uit een AI-beeldmodel, en elk woord en getal erop voegen wij zelf toe. Daarom labelen we ze als samengesteld.

    Onze hosting haalde dat veld echter weg. Daarom zeggen we het ook in gewone woorden op onze pagina over afbeeldingsgebruik. Wil je AI-afbeeldingen eerlijk labelen, vertrouw dan niet alleen op het veld in het bestand.

    Zet je je URL op de afbeelding zelf?

    Metadata is onzichtbaar en kwetsbaar; pixels niet. Screenshots, sociale media en AI-tools laten metadata vaak vallen, maar een kleine balk met je domein en de URL van het artikel overleeft ze allemaal. Daarom staat onder elke afbeelding op deze site nu het eigen adres.

    Afbeeldingen als startpunt van een zoekopdracht worden zo belangrijk dat Google ze apart rapporteert: met het nieuwe multimodale filter in Search Console zie je verkeer via Lens en Circle to Search.

    Houd het bescheiden: een dunne balk, geen watermerk over het onderwerp heen. Maak voor sociale media een aparte versie van 1200×630, zodat platforms je balk er niet af snijden.

    Onze mening
    Afbeeldingsmetadata laat een pagina niet hoger ranken, en Google beweert dat ook niet. Wat het wel doet: als je afbeelding rondgaat, via Google Afbeeldingen, Lens of iemands blog, gaan je naam en een link terug met haar mee. Voor een kleine site is dat een van de goedkoopste bronnen van naamsvermelding en links die er zijn.

    Veelgestelde vragen

    Gebruikt Google IPTC-metadata?

    Ja. Google haalt Creator, Credit Line, Copyright Notice, Web Statement of Rights, Licensor URL en Digital Source Type uit IPTC-fotometadata en kan die tonen in Google Afbeeldingen.

    Wat is nodig voor het licentielabel in Google Afbeeldingen?

    Met IPTC-metadata moet je het veld Web Statement of Rights invullen. Met structured data moet je de eigenschap license op het ImageObject zetten, samen met contentUrl.

    Wat als IPTC-metadata en structured data elkaar tegenspreken?

    Dan gebruikt Google de informatie uit de structured data.

    Helpt afbeeldingsmetadata voor je ranking?

    Google noemt het geen rankingfactor. Het wordt gebruikt om de maker te vermelden en licentie-informatie te tonen in Google Afbeeldingen. Alt-tekst, bestandsnaam en de tekst op de pagina helpen Google te begrijpen wat er op een afbeelding staat.

    Waarom mist de metadata op mijn live site?

    Beeldoptimalisatie, CDN’s en omzetting naar WebP zetten afbeeldingen vaak opnieuw om en laten daarbij metadata vallen. Download het live bestand, ook de WebP-versie, en lees het uit met ExifTool om te zien wat er echt overblijft.

    B
    Ben runt IndexUrePoint en beheert meerdere websites in Google Search Console en Bing Webmaster Tools, waaronder deze. De test in dit artikel is uitgevoerd op de afbeeldingen van deze site zelf. Fout gezien? Laat het weten via de contactpagina; we passen het aan en vermelden de datum. Deze gids is ook beschikbaar in het Engels.

  • AI-crawlers en robots.txt: GPTBot, ClaudeBot en Google-Extended toestaan of blokkeren

    AI-crawlers en robots.txt: GPTBot, ClaudeBot en Google-Extended toestaan of blokkeren

    Read this guide in English →

    AI-zoeken · robots.txt

    AI-bedrijven gebruiken verschillende crawlers voor verschillende taken — trainen, zoeken en ophalen namens een gebruiker — en met robots.txt sta je elk daarvan apart toe of blokkeer je hem: laat de zoekcrawlers binnen als je geciteerd wilt worden, en beslis bewust over de trainingscrawlers.

    Belangrijkste punten
    • Per bedrijf drie rollen: training (GPTBot, ClaudeBot), zoeken (OAI-SearchBot, Claude-SearchBot, PerplexityBot) en ophalen voor een gebruiker (ChatGPT-User, Claude-User, Perplexity-User).
    • Blokkeer je GPTBot, dan verdwijn je niet uit ChatGPT-zoeken; dat regelt OAI-SearchBot. Wijzigingen voor zoeken verwerkt OpenAI in ongeveer 24 uur.
    • Volgens hun eigen documentatie houden ChatGPT-User en Perplexity-User zich niet altijd aan robots.txt, omdat ze handelen op verzoek van een mens.
    • Google-Extended regelt Gemini-training en grounding in Gemini Apps en Vertex AI, maar heeft geen invloed op Google Zoeken of je ranking.
    • Microsoft heeft geen aparte AI-bot: Copilot gebruikt de Bing-index. Gebruik stuur je daar met de metatags noarchive en nocache.
    Hoe dit is gecontroleerd. Op 25 september 2026 nagelopen tegen de officiële crawlerdocumentatie van OpenAI, Anthropic, Perplexity, Google en de Bing Webmaster Blog. De voorbeelden komen uit de robots.txt van deze eigen site. Crawlerlijsten veranderen; we vermelden de datum.

    Welke AI-crawlers zijn er in 2026?

    De grote AI-bedrijven splitsen hun crawlers inmiddels op naar taak. Dat is goed nieuws: je hoeft niet meer te kiezen tussen “alles open” en “alles dicht”.

    • OpenAI: GPTBot verzamelt trainingsdata voor de modellen. OAI-SearchBot bepaalt of je in ChatGPT-zoeken verschijnt. ChatGPT-User haalt een pagina op wanneer een gebruiker daarom vraagt; volgens OpenAI zijn robots.txt-regels daar mogelijk niet van toepassing. Nieuw is OAI-AdsBot, dat pagina’s controleert die als advertentie in ChatGPT worden aangeboden.
    • Anthropic: ClaudeBot voor training, Claude-SearchBot voor zoekkwaliteit en Claude-User voor ophalen op verzoek van een gebruiker. Anthropic zegt robots.txt en Crawl-delay te respecteren.
    • Perplexity: PerplexityBot bouwt de zoekindex en wordt volgens Perplexity niet gebruikt voor modeltraining. Perplexity-User haalt pagina’s op tijdens een vraag en negeert robots.txt volgens de eigen documentatie “in het algemeen”.
    • Google: Google-Extended is geen aparte crawler maar een token in robots.txt; het crawlen gebeurt met de gewone Google-user-agents.
    • Apple: Applebot-Extended bepaalt of Apple je content voor AI-training mag gebruiken.
    Crawler Bedrijf Rol Blokkeren kost je
    GPTBot OpenAI Training Weinig zichtbaarheid; je data blijft uit toekomstige modellen
    OAI-SearchBot OpenAI ChatGPT-zoeken Bronvermeldingen in ChatGPT
    ChatGPT-User OpenAI Ophalen voor gebruiker Weinig effect; regels worden mogelijk niet toegepast
    ClaudeBot Anthropic Training Weinig zichtbaarheid
    Claude-SearchBot / Claude-User Anthropic Zoeken / ophalen Zichtbaarheid in Claude-antwoorden
    PerplexityBot Perplexity Zoekindex Bronvermeldingen in Perplexity
    Google-Extended Google Gemini-training en -grounding Niets in Google Zoeken
    Applebot-Extended Apple AI-training Niets in zoekresultaten

    Welke AI-crawlers moet je toestaan?

    ZOEKCRAWLERS

    Meestal toestaan

    Waarom: zij bepalen of je gevonden en geciteerd kunt worden in AI-antwoorden.

    TRAININGSCRAWLERS

    Jouw keuze

    Waarom: blokkeren houdt je content uit toekomstige modellen, met minder direct effect op je zichtbaarheid.

    Voor de meeste bedrijfssites, blogs en webshops is de verstandige standaard: zoekcrawlers toestaan. Als ChatGPT, Claude of Perplexity een vraag beantwoordt waar jij het beste antwoord op hebt, wil je als bron genoemd worden. Hoe je die kans vergroot, lees je in GEO-optimalisatie.

    Over trainingscrawlers kun je verschillend denken. Is je content zelf het product — betaald onderzoek, cursusmateriaal, een database — dan is blokkeren verdedigbaar. Is je content bedoeld om gevonden te worden, dan levert blokkeren weinig op en kan het op termijn betekenen dat modellen je merk minder goed kennen.

    Wat doet Google-Extended precies?

    Google-Extended bepaalt of content die Google crawlt gebruikt mag worden voor het trainen van toekomstige Gemini-modellen en voor grounding in Gemini Apps en Vertex AI. Google schrijft er uitdrukkelijk bij dat Google-Extended geen invloed heeft op opname in Google Zoeken en geen rankingsignaal is.

    Belangrijk voor wie denkt zich zo uit AI Overviews te houden: AI Overviews zijn onderdeel van Google Zoeken en werken met de gewone Googlebot-index. Google-Extended blokkeren haalt je daar dus niet uit. Wel kun je sinds 31 augustus 2026 je hele site uitsluiten van AI Overviews en AI Mode met de instelling Generatieve AI in Zoeken in Search Console (Instellingen), zonder uit de gewone zoekresultaten te verdwijnen — uitleg in onze gids over AI Overviews in Search Console (Engels). Wil je een pagina helemaal niet in Google, dan heb je noindex nodig — niet robots.txt.

    Hoe zit het met Bing en Microsoft Copilot?

    Microsoft werkt anders: er is geen aparte AI-crawler om te blokkeren. Copilot en de AI-antwoorden in Bing gebruiken de gewone Bing-index, gevuld door Bingbot. Blokkeer je Bingbot, dan verdwijn je uit Bing én uit Copilot.

    In plaats daarvan gebruikt Bing metatags. Volgens de aankondiging van Microsoft betekent nocache dat alleen URL, titel en fragment in chatantwoorden mogen verschijnen, en noarchive dat je content daar helemaal niet wordt gebruikt — terwijl je gewoon in de zoekresultaten blijft staan. De actuele lijst staat in Bings overzicht van ondersteunde robots-metatags. Hoe vaak Copilot je al citeert, zie je in het AI Performance-rapport van Bing Webmaster Tools.

    Voorbeeldregels voor robots.txt

    Variant 1 — AI-zoeken toestaan, AI-training blokkeren:

    User-agent: GPTBot
    Disallow: /
    
    User-agent: ClaudeBot
    Disallow: /
    
    User-agent: Google-Extended
    Disallow: /
    
    User-agent: Applebot-Extended
    Disallow: /

    Zoekcrawlers als OAI-SearchBot, Claude-SearchBot en PerplexityBot noem je niet; die mogen dan standaard alles, net als Googlebot en Bingbot.

    Variant 2 — alles toestaan (zoals op deze site):

    User-agent: *
    Disallow:
    
    Sitemap: https://indexurepoint.com/sitemap_index.xml

    Variant 3 — één map afschermen voor één bot:

    User-agent: GPTBot
    Disallow: /premium/

    Test elke wijziging in het robots.txt-rapport van Search Console en onthoud dat robots.txt een verzoek is, geen slot. Een pagina die je in robots.txt blokkeert, kan bovendien nog steeds in Google verschijnen — zonder beschrijving. Zie geblokkeerd door robots.txt.

    Hoe controleer je welke AI-bots je site bezoeken?

    • Serverlogs: zoek in je access-logs naar de user-agent-namen uit de tabel hierboven. De meeste hostingpartijen laten je de ruwe logs downloaden.
    • CDN of firewall: Cloudflare en vergelijkbare diensten tonen botverkeer per user-agent en laten je AI-bots per categorie toestaan of weren. Let op dat zo’n instelling niet stilletjes ook Bingbot of Googlebot tegenhoudt.
    • Echtheid controleren: iedereen kan zich GPTBot noemen. OpenAI, Google en anderen publiceren IP-reeksen waarmee je kunt nagaan of een bezoek echt van hen komt.
    • Resultaat meten: kijk in je analytics naar verwijzend verkeer van chatgpt.com, perplexity.ai en copilot.microsoft.com.

    Wat gaat er vaak mis?

    • Alles blokkeren uit voorzorg. Een regel als User-agent: * met Disallow: /, of een beveiligingsplugin die “alle AI-bots” weert, houdt je ook uit AI-zoeken.
    • Denken dat GPTBot = ChatGPT-zoeken. Dat zijn twee bots met twee rollen. Controleer welke je precies blokkeert.
    • Typefouten in de botnaam. GPT-Bot of Claudebot-Search bestaan niet; een onbekende naam wordt genegeerd.
    • Bingbot per ongeluk blokkeren. Daarmee verdwijn je uit Copilot én uit de bron waar ChatGPT-zoeken zwaar op leunt.
    • Verwachten dat het direct werkt. OpenAI en Perplexity noemen allebei tot ongeveer 24 uur voordat een wijziging verwerkt is.

    Voorbeeld: zo doen we het op deze site

    IndexUrePoint laat alle crawlers toe; onze robots.txt bestaat alleen uit User-agent: *, een lege Disallow en de verwijzing naar de sitemap. Daarnaast serveren we een /llms.txt (uitleg in het Engels) met een overzicht van onze Engelse en Nederlandse gidsen. Eerlijk is eerlijk: geen van de grote AI-bedrijven heeft bevestigd dat ze llms.txt gebruiken bij het bepalen van bronnen. Het kost niets en schaadt niet, maar het vervangt geen goede robots.txt, sitemap en indexering.

    Onze mening
    Blokkeer AI-zoekcrawlers bijna nooit: je verdwijnt dan uit de antwoorden waar je klanten steeds vaker beginnen. Over trainingscrawlers mag je bewust kiezen, maar doe het per bot en niet met een botte “alles dicht”-knop.

    Test je regels direct met onze gratis robots.txt-tester (Engels): in één klik zie je of GPTBot, ClaudeBot en Googlebot worden toegelaten of geblokkeerd.

    Veelgestelde vragen

    Verdwijn ik uit ChatGPT als ik GPTBot blokkeer?

    Niet vanzelf. ChatGPT-zoeken gebruikt OAI-SearchBot, die los van GPTBot wordt geregeld. GPTBot is de trainingscrawler van OpenAI.

    Schaadt het blokkeren van Google-Extended mijn Google-ranking?

    Nee. Google stelt dat Google-Extended geen invloed heeft op opname in Google Zoeken en geen rankingsignaal is.

    Houdt het blokkeren van Google-Extended mij uit AI Overviews?

    Nee. AI Overviews zijn onderdeel van Google Zoeken en gebruiken de gewone Googlebot-index. Google-Extended gaat over Gemini-training en grounding in Gemini Apps en Vertex AI. Wil je uit AI Overviews, gebruik dan de instelling Generatieve AI in Zoeken in Search Console.

    Houden alle AI-bots zich aan robots.txt?

    De gedocumenteerde crawlers van de grote bedrijven wel. Bots die handelen op verzoek van een gebruiker, zoals ChatGPT-User en Perplexity-User, volgen robots.txt volgens hun eigen documentatie niet altijd, en onbekende scrapers kunnen het volledig negeren.

    Hoe blokkeer ik Microsoft Copilot?

    Er is geen aparte Copilot-crawler. Met de metatag noarchive gebruikt Bing je content niet in chatantwoorden, met nocache alleen URL, titel en fragment. Bingbot blokkeren haalt je ook uit Bing-zoeken.

    Hoe lang duurt het voordat een wijziging in robots.txt werkt?

    OpenAI en Perplexity noemen tot ongeveer 24 uur. Google leest robots.txt doorgaans ook binnen een dag opnieuw.

    Hoe zie ik welke AI-bots mijn site bezoeken?

    Zoek in je serverlogs of in de botstatistieken van je CDN naar de user-agents GPTBot, OAI-SearchBot, ClaudeBot, Claude-SearchBot en PerplexityBot.

    Heb ik een llms.txt nodig?

    Het is optioneel. Geen van de grote AI-bedrijven heeft bevestigd dat ze het gebruiken voor bronselectie. Een goede robots.txt, sitemap en indexering zijn belangrijker.

    B
    Ben runt IndexUrePoint en beheert meerdere websites in Google Search Console en Bing Webmaster Tools, waaronder deze. Hij test elke instelling uit deze gids eerst op een live site voordat hij erover schrijft. Een fout gezien? Laat het weten via de contactpagina; we passen het aan en vermelden de datum.
  • Bing Webmaster Tools: uitleg en instellen in 10 minuten (gids 2026)

    Bing Webmaster Tools: uitleg en instellen in 10 minuten (gids 2026)

    Read this guide in English →

    Bing · Webmaster Tools · gids 2026

    Bing Webmaster Tools is de gratis tegenhanger van Google Search Console van Microsoft: je ziet hoe Bing je site crawlt, indexeert en rankt — en sinds februari 2026 ook hoe vaak Microsoft Copilot je pagina’s als bron noemt in AI-antwoorden.

    Belangrijkste punten
    • Instellen kost ongeveer 10 minuten: site toevoegen (of importeren uit Search Console), verifiëren, sitemap indienen, IndexNow koppelen.
    • Bing zelf is in Nederland klein — ongeveer 3,7% van alle zoekopdrachten in augustus 2026 (StatCounter) — maar de Bing-index wordt veel breder gebruikt dan bing.com.
    • In een onderzoek met 100 zoekvragen kwam 87% van de bronnen van ChatGPT-zoeken overeen met de topresultaten van Bing (Seer Interactive, 2025).
    • Het rapport AI Performance (openbare preview sinds 10 februari 2026) toont vermeldingen in Copilot en de AI-samenvattingen van Bing — data die Google Search Console niet apart laat zien.
    • IndexNow meldt nieuwe URL’s binnen seconden bij Bing; volgens Microsoft kwam 17% van de aangeklikte nieuwe URL’s in Bing via IndexNow binnen.
    • Er is geen officiële koppeling met ChatGPT, Claude of BigQuery; elke koppeling loopt via de Bing Webmaster API met een API-key (Settings → API Access).
    Hoe dit is gecontroleerd. Uit eigen ervaring: op 24 september 2026 hebben we indexurepoint.com toegevoegd aan Bing Webmaster Tools, geverifieerd met de metatag, onze sitemapindex ingediend en IndexNow gekoppeld. Al het andere is herleid naar Microsofts eigen documentatie of naar genoemde onderzoeken, met een link in de tekst. Reddit-discussies noemen we alleen op basis van hun openbare titels en zoekfragmenten. De sectie over koppelen aan ChatGPT, Claude en BigQuery en de update over Topics Portfolio zijn op 18 oktober 2026 nagelezen in Microsofts API-documentatie en op het Bing Webmaster-blog.

    Wat is Bing Webmaster Tools?

    Bing Webmaster Tools is een gratis dashboard van Microsoft voor website-eigenaren. Het laat zien welke pagina’s Bing heeft gevonden en geïndexeerd, op welke zoekopdrachten je verschijnt, welke sites naar je linken en welke technische problemen Bing tegenkwam tijdens het crawlen. Microsoft heeft ook een Nederlandstalige helppagina, al is het dashboard zelf grotendeels Engelstalig.

    Microsofts eigen Webmaster Guidelines beschrijven inmiddels hoe Bing content toont in Bing-zoekresultaten, in Copilot en in resultaten van de grounding-API. Met andere woorden: dezelfde index voedt de klassieke zoekmachine, Microsofts AI-assistent én externe diensten die hun antwoorden op Bing baseren.

    Waarom doet Bing ertoe als Google 90% marktaandeel heeft?

    Omdat de Bing-index veel verder reikt dan bing.com. In Nederland had Google in augustus 2026 bijna 90% van de zoekopdrachten en Bing ongeveer 3,7% (StatCounter); wereldwijd was dat 91,1% tegen 4,5%. Maar AI-assistenten veranderen die rekensom.

    3,7%aandeel van Bing in Nederlandse zoekopdrachten, aug. 2026 — StatCounter
    87%van de ChatGPT-zoekbronnen kwam overeen met de topresultaten van Bing (100 vragen, 500+ bronnen) — Seer Interactive
    17%van de aangeklikte nieuwe URL’s in Bing kwam via IndexNow — Fabrice Canel, Microsoft, via Search Engine Land
    10.000URL’s per dag: het maximale quotum voor handmatig indienen — Search Engine Journal
    2.400Nederlandse zoekopdrachten per maand naar “bing webmaster tools”; 1.600 in eind 2025, 2.900 in juli–aug. 2026 (DataForSEO, sept. 2026)

    Seer vergeleek de bronnen van ChatGPT met de resultaten van Google en Bing voor dezelfde vragen: Bing kwam voor 87% overeen, Google voor 56%. Dat is niet het hele verhaal — experimenten waarover Semrush rapporteerde wijzen erop dat betaalde ChatGPT-versies ook Google gebruiken — maar de les is eenvoudig: als Bing je niet kan indexeren, mis je in een groot deel van de AI-antwoorden. Daarom zien wij Bing als pijler van GEO-optimalisatie, niet als bijzaak.

    Hoe stel je Bing Webmaster Tools in? (10 minuten)

    Microsofts Getting Started Checklist noemt dezelfde basisstappen. Zo verliepen ze op deze site.

    Stap 1 — Inloggen

    Ga naar bing.com/webmasters en log in met een Microsoft-, Google- of Facebook-account. Een aparte registratie is niet nodig.

    Stap 2 — Site toevoegen

    Je hebt twee keuzes. Importeren uit Google Search Console is het snelst: je geverifieerde properties en hun sitemaps komen mee zonder aparte verificatie, maar je geeft Bing leestoegang tot je Search Console-gegevens. Handmatig toevoegen betekent je URL invullen en zelf verifiëren. Wij kozen handmatig, om de accounts gescheiden te houden. Heb je Search Console nog niet ingesteld? Begin dan met je website aanmelden bij Google.

    Stap 3 — Eigendom verifiëren

    Er zijn drie methoden: een XML-bestand (BingSiteAuth.xml) in de hoofdmap van je site, een msvalidate.01-metatag op je homepage, of een CNAME-record in je DNS. Op WordPress is de metatag het eenvoudigst — Yoast SEO heeft er een veld voor. Wij plaatsten de tag, klikten op Verify, en de site verscheen direct in het dashboard.

    Stap 4 — Sitemap indienen

    Open Sitemaps → Submit sitemap en vul je sitemap-URL in — met Yoast of Rank Math meestal /sitemap_index.xml. Die van ons stond binnen enkele seconden op “Processing”. Meldt Bing een fout, dan zijn de oorzaken dezelfde als bij Google: zie sitemap kan niet worden gelezen.

    Stap 5 — IndexNow koppelen

    Installeer de officiële IndexNow-plugin (of zet IndexNow aan in je SEO-plugin), zodat elke nieuwe of gewijzigde URL direct naar Bing gaat. Op het moment van schrijven had deze site 100 IndexNow-meldingen verstuurd, zonder één mislukking. Meer daarover in wat is IndexNow.

    Hoe verhoudt Bing Webmaster Tools zich tot Google Search Console?

    De basis overlapt, de extra’s verschillen. Bing is gulder met gratis onderzoeksdata; Google heeft het grootste publiek.

    Functie Bing Webmaster Tools Google Search Console
    Zoekprestaties (klikken, vertoningen, zoekopdrachten) Ja Ja
    URL-inspectie Ja Ja
    Rapport over AI-vermeldingen Ja — AI Performance (openbare preview) Geen apart rapport; AI-functies vallen onder Prestaties
    Backlinkdata Ja — verwijzende domeinen en ankerteksten Beperkt Links-rapport
    Zoekwoordonderzoek Ja, op basis van Bing-data Nee
    Site-audit op aanvraag Ja — Site Scan Nee
    URL direct doorgeven IndexNow (automatisch) Indexering aanvragen (handmatig, daglimiet)
    Verificatie XML-bestand, metatag, CNAME of import uit Google DNS, HTML-bestand, metatag, Analytics, Tag Manager

    Ook in de praktijk vallen die extra’s op: in een r/bigseo-discussie met de titel “Anyone here actively using Bing Webmaster Tools?” noemt iemand de backlinkdata “surprisingly good”.

    Wat laat het AI Performance-rapport zien?

    Microsoft introduceerde AI Performance op 10 februari 2026 als openbare preview. Het rapport dekt Microsoft Copilot, AI-samenvattingen in Bing en een aantal partnerintegraties, met vijf weergaven: totaal aantal vermeldingen, gemiddeld aantal geciteerde pagina’s, grounding-zoekvragen, vermeldingen per pagina en de trend in de tijd. Op 13 oktober 2026 voegde Microsoft daar Topics Portfolio (bèta) aan toe, dat de grounding-zoekvragen waarbij je site verschijnt groepeert in bredere thema’s.

    De beperkingen zijn belangrijk. Zoals Search Engine Land opmerkte, meten de cijfers alleen hoe vaak je wordt geciteerd — geen klikken, geen verkeer en geen indicatie van hoe prominent je bron werd gebruikt. Zie het als een zichtbaarheidssignaal en controleer echte bezoeken in je analytics. Wil je vaker geciteerd worden, pas dan de aanpak uit GEO-optimalisatie toe, en zorg dat je de crawler van Microsoft niet blokkeert — zie AI-crawlers en robots.txt.

    Waar past IndexNow in?

    Bing Webmaster Tools laat zien wat Bing over je site weet; IndexNow is de manier om Bing direct te vertellen dat er iets veranderd is. In plaats van te wachten tot Bingbot opnieuw langskomt, stuurt je site bij elke nieuwe, gewijzigde of verwijderde URL een seintje naar Bing. In het IndexNow-onderdeel van het dashboard zie je wat er binnenkwam.

    Handmatig URL’s indienen kan nog steeds — Bing verhoogde het dagquotum van 10 naar maximaal 10.000 URL’s, afhankelijk van hoe lang een site al geverifieerd is (Search Engine Journal) — maar IndexNow doet hetzelfde automatisch. Google doet niet mee aan IndexNow; voor Google blijf je afhankelijk van sitemaps en interne links. Hoe lang dat duurt, lees je in hoe lang duurt indexeren bij Google.

    Kun je Bing Webmaster Tools koppelen aan ChatGPT, Claude of BigQuery?

    Niet met een officiële koppeling met één klik: Microsoft publiceert er geen voor ChatGPT, Claude, BigQuery, Google Sheets, Looker Studio of Power BI (gecontroleerd op 17 oktober 2026). Wat Microsoft wel biedt, is de Bing Webmaster API, en elke werkende koppeling loopt daarlangs.

    Toegang krijg je op twee manieren: met OAuth 2.0, dat Microsoft aanraadt voor apps, of met een API-key. Voor de key open je Bing Webmaster Tools en klik je op Settings (rechtsboven) → API Access → Generate API Key; de eerste keer accepteer je eerst de voorwaarden. Per gebruiker kan er maar één key worden aangemaakt. De key hoort bij je gebruikersaccount en niet bij één site, dus behandel hem als een wachtwoord. Denk je dat hij is uitgelekt, verwijder hem dan en maak een nieuwe; apps die de oude key gebruikten, werken daarna niet meer.

    De API dekt dezelfde data als de belangrijkste rapporten. Bruikbare methoden in de officiële referentie zijn onder meer GetQueryStats en GetPageStats (verkeer voor je belangrijkste zoekopdrachten en pagina’s), GetPageQueryStats, GetRankAndTrafficStats, GetCrawlStats, GetCrawlIssues, GetUrlInfo, GetKeywordStats, SubmitUrl en SubmitUrlBatch. Het AI Performance-rapport staat niet in de API-referentie; citatiedata blijven dus voorlopig in het dashboard.

    Koppelen aan Officiële koppeling? Route die werkt
    ChatGPT Nee Een custom GPT-action of een eigen script dat de API aanroept met je key
    Claude / Claude Code Nee Een MCP-server die de API aanroept (door de community gebouwd, zie hieronder) of een script dat Claude Code voor je draait
    BigQuery Nee Een ingepland script (bijvoorbeeld een Cloud Run-job) dat GetQueryStats en GetPageStats ophaalt en in een tabel laadt
    Google Sheets Nee Apps Script met UrlFetchApp dat de API aanroept, of importeer de CSV via de knop Download in het rapport Search Performance
    Looker Studio Nee Connectors van derden (soms betaald), of Looker Studio bovenop je BigQuery-tabel
    Power BI Nee Power Query “Van web” op de API, of een dataset die je met een script vult
    Over “Bing Webmaster Tools MCP-servers”
    De MCP-servers die je op GitHub vindt voor Claude en andere assistenten zijn gebouwd door individuele ontwikkelaars, niet door Microsoft. Ze gebruiken je API-key, meestal via een omgevingsvariabele zoals BING_WEBMASTER_API_KEY. Lees de code voordat je er een installeert, en houd de key buiten gedeelde configuraties en coderepository’s.

    Voor de meeste sites is de eenvoudigste nuttige opzet een wekelijks script dat zoekopdracht- en paginastatistieken in een sheet of BigQuery-tabel zet, naast je Search Console-data. Zo zie je naast elkaar welke pagina’s Google en Bing echt indexeren en welke zoekopdrachten elke zoekmachine stuurt. Die vergelijking is ook de snelste manier om te zien of Bing achterloopt, wat volgens het onderzoek hierboven direct doorwerkt in ChatGPT-zoeken; zie GEO-optimalisatie.

    Wat gaat er mis — en hoe los je het op?

    • “Is het überhaupt de moeite waard?” — een veelgehoorde twijfel, bijvoorbeeld in deze r/growmybusiness-discussie. Tien minuten instellen levert je Bing, Copilot en een deel van de bronnen van ChatGPT op. Ja, het is de moeite waard.
    • Geïndexeerd volgens het dashboard, maar onvindbaar. Een gebruiker op r/bing meldde dat zijn site uit de index was verdwenen terwijl het portaal hem nog als geïndexeerd toonde. Gebruik de live-check van URL Inspection en bevestig met een site:-zoekopdracht op Bing.
    • Bingbot geblokkeerd. Een firewall- of robots.txt-regel die Googlebot wel doorlaat maar Bingbot niet, houdt je ongemerkt buiten de deur. Controleer beide — zie geblokkeerd door robots.txt.
    • Verificatie verdwijnt. Bing controleert de verificatie opnieuw. Haal je de metatag weg tijdens een redesign, dan verlies je de toegang.
    • Pagina’s gevonden maar niet geïndexeerd. Bing slaat, net als Google, dunne of dubbele pagina’s over. De oplossingen uit gecrawld vs. gevonden en canonieke URL’s gelden hier ook.
    • Dubbele IndexNow-meldingen. Meerdere plugins die dezelfde URL’s insturen, verspillen quotum. Kies één methode.

    Hoe ging het op deze site, van nul naar geïndexeerd?

    Na het koppelen van IndexNow publiceerden we op 24 september 2026 negen nieuwe gidsen. Elke publicatie ging automatisch als IndexNow-melding naar Bing, en de sitemap werd tegelijk bij Google ingediend. Aan de Google-kant waren acht van de negen gidsen een dag later al geïndexeerd — geholpen door interne links vanaf pagina’s die al in de index stonden. Die combinatie van sitemap, IndexNow en interne links is precies wat we hierboven aanraden: niets ervan kost geld, alles is in een middag geregeld.

    Onze mening
    Bing Webmaster Tools is op dit moment de goedkoopste zichtbaarheidswinst in SEO: tien minuten instellen, gratis onderzoeksdata en een directe lijn naar de index achter Copilot en een groot deel van ChatGPT-zoeken. Stel het in op dezelfde dag als Search Console en laat IndexNow het actueel houden.

    Veelgestelde vragen

    Is Bing Webmaster Tools gratis?

    Ja. Alle functies, inclusief Site Scan, backlinkdata, zoekwoordonderzoek en het AI Performance-rapport, zijn gratis met een Microsoft-, Google- of Facebook-login.

    Moet ik mijn site aan Bing Webmaster Tools koppelen als ik al Google Search Console gebruik?

    Ja. De twee tools dekken verschillende indexen. Die van Bing voedt Bing-zoeken, Microsoft Copilot en partners, en is de enige die AI-vermeldingen apart rapporteert.

    Kan ik mijn site importeren uit Google Search Console?

    Ja. De import voegt je geverifieerde Search Console-sites en hun sitemaps toe zonder aparte verificatie, nadat je Bing leestoegang tot je Search Console-gegevens geeft.

    Gebruikt iemand in Nederland nog Bing?

    Rechtstreeks ongeveer 3,7% van de zoekopdrachten in augustus 2026, volgens StatCounter. Indirect veel meer: de Bing-index voedt Microsoft Copilot en is een belangrijke bron voor de bronvermeldingen van ChatGPT-zoeken.

    Is Bing Webmaster Tools beschikbaar in het Nederlands?

    Microsoft biedt Nederlandstalige hulp- en aanmeldpagina’s, maar veel rapporten en menu’s in het dashboard zijn Engelstalig. De stappen in deze gids gebruiken daarom de Engelse menunamen.

    Hoeveel URL’s kan ik per dag bij Bing indienen?

    Handmatig indienen staat tot 10.000 URL’s per dag toe, afhankelijk van hoe lang je site geverifieerd is en andere signalen. IndexNow-meldingen staan daar los van en gaan automatisch.

    Hoe lang duurt het voordat Bing een nieuwe site indexeert?

    Met een sitemap en IndexNow ontdekt Bing nieuwe URL’s meestal snel. Of ze ook worden geïndexeerd, hangt af van kwaliteit en vertrouwen; bij nieuwe sites kan dat dagen tot weken duren.

    Toont het AI Performance-rapport klikken vanuit Copilot?

    Nee. Het toont hoe vaak je wordt geciteerd, welke pagina’s en bij welke grounding-zoekvragen, maar geen klikken of verkeer. Verwijzend verkeer vanuit Copilot zie je in je analytics.

    Waarom sta ik wel in Google maar niet in Bing?

    Veelvoorkomende oorzaken zijn een blokkade van Bingbot in robots.txt of een firewall, geen ingediende sitemap, of content die Bing te dun vindt. Kijk bij URL Inspection in Bing Webmaster Tools voor de precieze reden.

    Kan ik Bing Webmaster Tools koppelen aan ChatGPT?

    Niet via een officiële koppeling. Maak onder Settings → API Access een API-key aan en roep de Bing Webmaster API aan vanuit een custom GPT-action of een eigen script.

    Is er een officiële Bing Webmaster Tools MCP-server voor Claude of Claude Code?

    Nee. De MCP-servers op GitHub zijn communityprojecten die de officiële Bing Webmaster API met jouw API-key aanroepen. Bekijk de code voordat je er een installeert.

    Kan ik data uit Bing Webmaster Tools naar BigQuery of Google Sheets halen?

    Niet ingebouwd. Een ingepland script dat GetQueryStats en GetPageStats aanroept, kan de data in BigQuery of een sheet laden; het AI Performance-rapport is niet via de API beschikbaar.

    B
    Ben runt IndexUrePoint en beheert meerdere websites in Google Search Console en Bing Webmaster Tools, waaronder deze. Hij test elke instelling uit deze gids eerst op een live site voordat hij erover schrijft. Een fout gezien? Laat het weten via de contactpagina; we passen het aan en vermelden de datum.
  • Sitemap kan niet worden gelezen of opgehaald: zo los je het op

    Sitemap kan niet worden gelezen of opgehaald: zo los je het op

    Read this guide in English →

    Google Search Console · Sitemaps

    “Sitemap kan niet worden gelezen” of “Kan niet worden opgehaald” betekent dat Google je sitemap probeerde te laden en dat dat mislukte — verkeerde URL, een blokkade, kapotte XML, of gewoon een verse indiening die nog verwerkt wordt.

    Belangrijkste punten
    • Eerste check: open de sitemap-URL zelf in een privévenster. Laadt hij netjes → meestal wachten; faalt hij → URL, blokkade of XML repareren.
    • De klassieke fout: /sitemap.xml indienen terwijl je plugin /sitemap_index.xml serveert.
    • Bij gloednieuwe sites springt “Kan niet worden opgehaald” vaak vanzelf binnen dagen op “Succesvol” — bij ons binnen minuten.
    • Limieten: 50.000 URL’s of 50 MB per sitemap; daarboven splitsen met een sitemapindex.
    • Een sitemap is een vindhulp, geen indexeerknop: goed gelinkte pagina’s worden ook zónder gevonden.
    Hoe dit is gecontroleerd. Geschreven op basis van Google’s sitemapdocumentatie en de hulp bij het Sitemaps-rapport.
    Kort antwoord

    Als Search Console zegt dat je sitemap niet kan worden gelezen of opgehaald, probeerde Google hem te laden en lukte dat niet: een fout, een blokkade of een bestand dat niet te lezen is.

    Open eerst zelf de sitemap-URL in je browser. Laadt hij als nette lijst, dan ligt het meestal aan Google’s kant of is een nieuwe inzending nog in behandeling — geef het een paar dagen. Laadt hij niet, los dan de URL, blokkade of XML-fout hieronder op.

    De check van 2 minuten

    Plak je exacte sitemap-URL in een privévenster van je browser.
    Hij laadt als lijst met URL’s
    1. Is het precies de URL die je indiende?
    2. Test hem met URL-inspectie → Live URL testen.
    3. Net ingediend? Wacht een paar dagen en dien één keer opnieuw in.
    Foutmelding, doorverwijzing of HTML
    1. 404? Verkeerde URL ingediend.
    2. Inlog-, firewall- of controlepagina? Googlebot wordt geblokkeerd.
    3. Rommel of leeg scherm? De XML is kapot.

    Wat je in de browser ziet Waarschijnlijke oorzaak Oplossing
    404 Verkeerde sitemap-URL ingediend De URL indienen die je plugin maakt
    Login- of controlepagina Firewall/botbescherming blokkeert Googlebot Geverifieerde zoekbots doorlaten
    Leeg of rommelig scherm Kapotte XML of cacheplugin XML valideren; sitemap uit de cache
    Laadt perfect Verse indiening of vertraging bij Google Paar dagen wachten, één keer opnieuw

    De echte oorzaken

    • Verkeerde URL. Yoast en Rank Math gebruiken /sitemap_index.xml; WordPress zonder SEO-plugin /wp-sitemap.xml. Uit gewoonte /sitemap.xml indienen is de klassieke fout.
    • Geblokkeerd voor Googlebot door robots.txt, een beveiligingsplugin, firewall of botbescherming.
    • Kapotte XML: lege regels of PHP-waarschuwingen vóór <?xml, of een cacheplugin die een geminificeerde HTML-versie serveert.
    • Te groot. Eén sitemap mag maximaal 50.000 URL’s of 50 MB (ongecomprimeerd) bevatten.
    • Serverfouten of time-outs op het moment dat Google hem ophaalde.
    • Net ingediend. Bij nieuwe sites toont het rapport vaak een tijd “Kan niet worden opgehaald”, ook als het bestand prima is.

    Oplossingen die werken

    • Dien de exacte URL in die je plugin maakt en verwijder oude inzendingen.
    • Sluit sitemaps uit van cache en minificatie en laat Googlebot door in je beveiligingsinstellingen.
    • Valideer de XML met een online sitemap-validator.
    • Zet de sitemap in robots.txt met een Sitemap:-regel, zodat ook Bing hem vindt.
    • Dien na het oplossen één keer opnieuw in. Vaker helpt niet.
    Onze mening
    Een sitemap helpt bij ontdekken; het is geen indexeringsknop. Goed intern gelinkte pagina’s worden ook gevonden als de sitemap even hapert. Worden pagina’s wel gevonden maar niet geïndexeerd, lees dan Gecrawld vs. Gevonden.

    Veelgestelde vragen

    Waarom zegt Search Console “Kan niet worden opgehaald” terwijl mijn sitemap werkt?

    Bij nieuwe inzendingen verschijnt deze status vaak tijdelijk. Laadt het bestand voor gewone bezoekers en slaagt een live test, wacht dan een paar dagen. Blijft het, controleer dan firewall- of botbeschermingsregels.

    Houdt een sitemapfout mijn site uit Google?

    Nee. Google vindt pagina’s ook via links. Een werkende sitemap helpt vooral bij nieuwe of grote sites.

    Hoeveel URL’s mag een sitemap bevatten?

    Maximaal 50.000 URL’s of 50 MB ongecomprimeerd. Daarboven splits je hem en dien je een sitemapindex in.

    Moet ik mijn sitemap ook bij Bing indienen?

    Ja, via Bing Webmaster Tools, en zet de Sitemap-regel in robots.txt. Voor directe updates in Bing gebruik je ook IndexNow.

    Hoort mijn sitemap in robots.txt te staan?

    Ja, met een Sitemap:-regel en de volledige URL. Alle grote crawlers, ook Bing, lezen hem daar zelfs zonder handmatige indiening.

    Kan ik meerdere sitemaps indienen?

    Ja: meerdere losse sitemaps of één sitemapindex die ze allemaal aanwijst. Search Console toont per sitemap een eigen status.

    iP
    IndexUrePoint is een onafhankelijke gids over hoe je je pagina’s gevonden en geïndexeerd krijgt — Google, Bing en AI-zoeken. We testen tools zelf en zeggen het eerlijk wanneer iets niet werkt. Fout gespot? Laat het ons weten via de contactpagina; we verbeteren het en vermelden de datum.

  • Pagina met omleiding in Search Console: normaal of een probleem?

    Pagina met omleiding in Search Console: normaal of een probleem?

    Read this guide in English →

    Google Search Console · Omleidingen

    “Pagina met omleiding” betekent dat de URL bezoekers doorstuurt, waardoor Google de bestemming indexeert — meestal precies de bedoeling. De kwade tweeling “Fout met omleiding” (lussen, lange ketens) moet je wél altijd repareren.

    Belangrijkste punten
    • Een lange lijst “Pagina met omleiding” na een https-migratie of herontwerp is een teken dat het goed ging.
    • Grijp alleen in als doorverwijzende URL’s in je sitemap staan, intern gelinkt worden of verkeerd uitkomen.
    • “Fout met omleiding” = lus, te lange keten of kapotte stap — test met een live URL-inspectie.
    • Permanente verhuizingen op 301/308, en elke redirect in één stap: A→C, niet A→B→C.
    • Volgens Google kosten server-side redirects geen PageRank; ketens verspillen alleen crawlwerk.
    Hoe dit is gecontroleerd. Geschreven op basis van Google’s documentatie over het rapport Pagina-indexering en zijn richtlijnen over doorverwijzingen en verhuizingen van sites.
    Kort antwoord

    “Pagina met omleiding” betekent dat deze URL doorverwijst naar een andere, dus Google indexeert de bestemming en niet deze URL. Dat is normaal en meestal precies goed.

    Actie is alleen nodig als een doorverwijzende URL nog in je sitemap staat, intern gelinkt wordt, of naar de verkeerde plek gaat. De boze tweeling, “Fout met omleiding” — lussen, lange ketens, kapotte doelen — moet je altijd oplossen.

    Wat “Pagina met omleiding” betekent

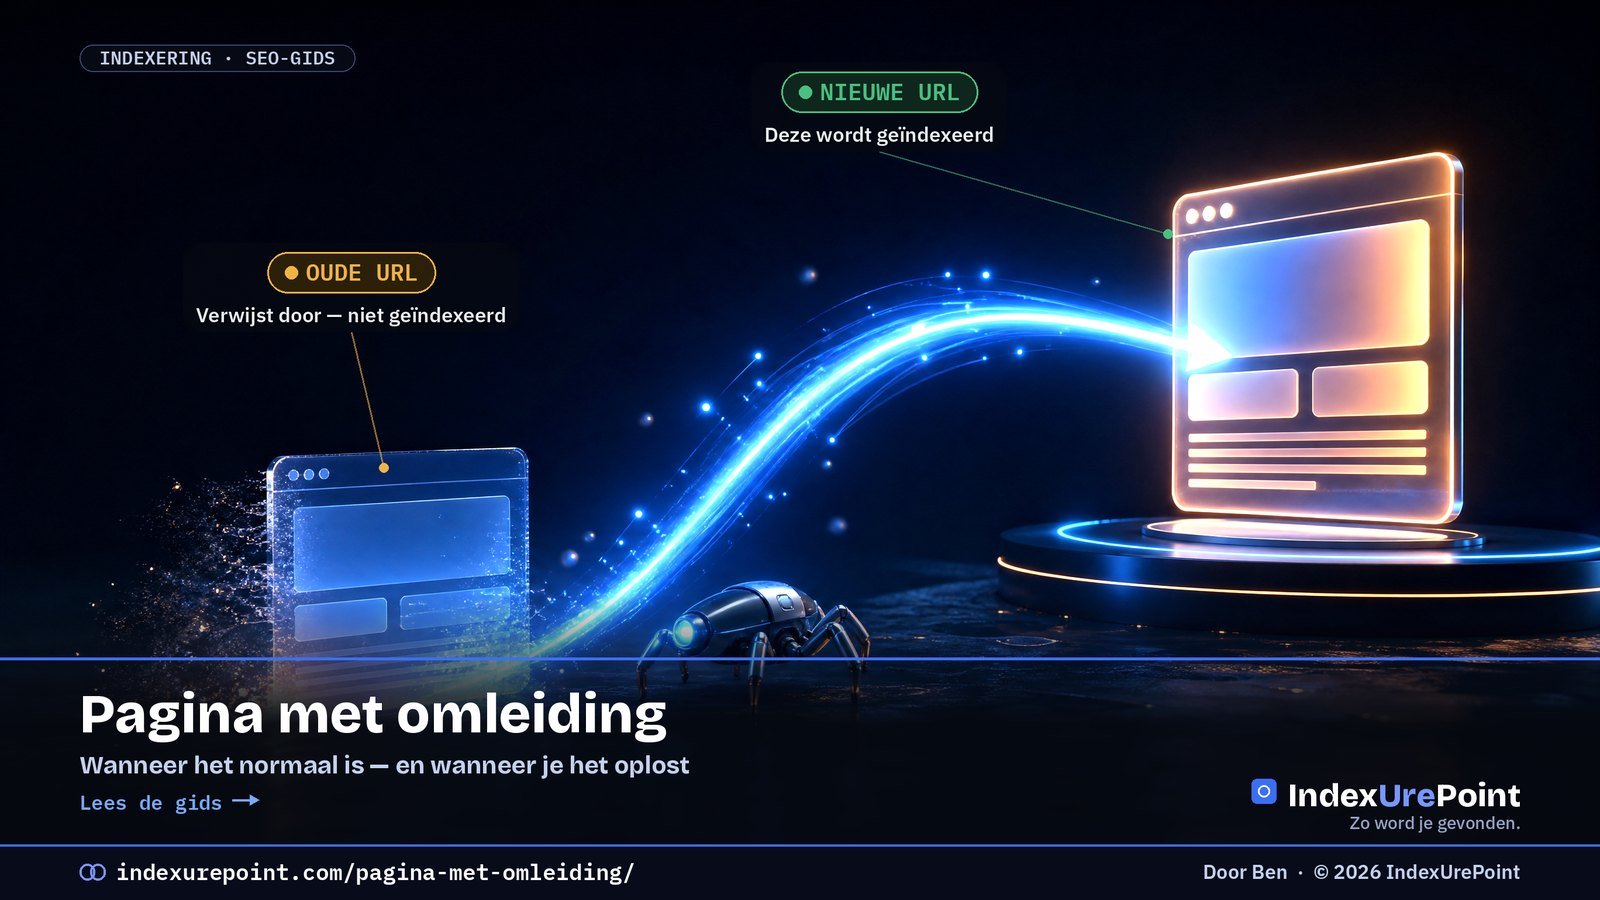
    OUDE URL

    Verwijst door

    Status: “Pagina met omleiding” — bewust niet geïndexeerd.

    NIEUWE URL

    Wordt geïndexeerd

    Status: hoort geïndexeerd te zijn en neemt de signalen van de oude URL over.

    Normaal of oplossen?

    • Normaal: http → https, met of zonder www, oude slugs na het hernoemen van een bericht, verwijderde pagina’s doorverwezen naar een echte vervanger.
    • Oplossen: doorverwijzende URL’s in je XML-sitemap. Een sitemap hoort alleen definitieve, indexeerbare URL’s te bevatten.
    • Oplossen: menu’s en interne links die naar een doorverwijzende URL wijzen. Link direct naar de eindbestemming.
    • Oplossen: een pagina die je wilt laten ranken maar onverwacht doorverwijst — vaak een pluginregel of taal-doorverwijzing.
    Situatie Status Actie
    http → https, www-normalisatie, nieuwe slugs Pagina met omleiding Geen — werkt zoals bedoeld
    Doorverwijzende URL in sitemap of menu Pagina met omleiding Sitemap/links naar de eind-URL wijzen
    Lus of keten zonder einde Fout met omleiding Op één laag oplossen; keten platslaan
    Verwijderde pagina’s massaal naar home Soft 404 Naar echte equivalenten, of 404/410

    “Fout met omleiding” — die moet je oplossen

    Deze aparte status betekent dat Google de doorverwijzing niet kon afmaken: een te lange keten, een lus, een URL die te lang werd, of een lege of kapotte URL in de keten. Test de URL met URL-inspectie en laat elke oude URL in één 301-stap naar de eindbestemming gaan.

    Let op lussen
    Lussen ontstaan vaak doordat twee systemen elkaar tegenwerken, bijvoorbeeld een CDN dat https afdwingt terwijl de server http afdwingt. Los het op één plek op.
    Onze mening
    Een lange lijst “Pagina met omleiding” na een verhuizing naar https of een nieuw ontwerp betekent dat het goed ging. Steek je energie in de sitemap, interne links en eventuele “Fout met omleiding”-meldingen. Stuur verwijderde pagina’s niet allemaal naar de homepage — dat ziet Google vaak als soft 404.

    Een uitgewerkt voorbeeld

    Stel: je hernoemt een artikel van /seo-tips/ naar /seo-tips-2026/. WordPress maakt automatisch een redirect van de oude naar de nieuwe slug. In Search Console verschijnt de oude URL daarna als “Pagina met omleiding” — correct, geen actie nodig. Wél actie nodig: je interne links en eventuele menu-items nog naar /seo-tips/ laten wijzen. Elke klik en elke crawl maakt dan een extra stap. Werk je een jaar later de titel opnieuw bij naar /seo-tips-2027/, controleer dan of de oudste URL rechtstreeks naar de nieuwste gaat, en niet via de tussenversie — zo houd je elke omleiding op één stap en blijft “Fout met omleiding” buiten de deur.

    Veelgestelde vragen

    Moet ik “Pagina met omleiding” oplossen?

    Meestal niet. Alleen als de URL in je sitemap staat, intern gelinkt wordt, of een pagina is die je eigenlijk geïndexeerd wilde hebben.

    Moet ik hier “Oplossing valideren” gebruiken?

    Niet als de doorverwijzingen bewust zijn. De URL’s blijven in het rapport staan zolang Google ze kent, en dat is prima.

    Verlies ik rankingwaarde door doorverwijzingen?

    Google heeft gezegd dat 301- en andere server-side doorverwijzingen geen PageRank kosten. Ketens vertragen wel het crawlen, dus houd het bij één stap.

    301 of 302?

    Gebruik 301 (of 308) voor permanente verhuizingen. 302 en 307 betekenen tijdelijk; Google kan de oude URL dan langer geïndexeerd houden.

    Hoe lang moet ik redirects na een migratie laten staan?

    Google adviseert minimaal een jaar; langer kost niets en behoudt de waarde van oude links.

    Maken redirects mijn site langzamer?

    Elke stap kost een extra rondreis voor bezoekers en crawlers. Eén stap is prima; ketens van drie of meer zijn het platslaan waard.

    iP
    IndexUrePoint is een onafhankelijke gids over hoe je je pagina’s gevonden en geïndexeerd krijgt — Google, Bing en AI-zoeken. We testen tools zelf en zeggen het eerlijk wanneer iets niet werkt. Fout gespot? Laat het ons weten via de contactpagina; we verbeteren het en vermelden de datum.

  • Soft 404-fout: wat het is en hoe je het oplost

    Soft 404-fout: wat het is en hoe je het oplost

    Read this guide in English →

    Google Search Console · Pagina-indexering

    Een soft 404 is een pagina die de browser “200 OK” meldt maar er voor Google leeg of verdwenen uitziet — dus behandelt Google hem als niet gevonden en blijft hij uit de index.

    Belangrijkste punten
    • De statuscode zegt “pagina bestaat”, de inhoud zegt “hier is niets” — Google gelooft de inhoud.
    • Zes vaste oorzaken: nep-404’s met code 200, lege archieven, uitgeklede productpagina’s, irrelevante redirects, placeholders en mislukte JavaScript-rendering.
    • Verwijderde pagina’s massaal naar de homepage sturen wordt zélf als soft 404 behandeld.
    • De oplossing volgt het paginatype: weg → echte 404/410; verhuisd → 301 naar het equivalent; echt → echte inhoud.
    • Bij JavaScript-sites: test de live URL in Search Console; een lege schermafbeelding betekent dat Google niets ziet.
    Hoe dit is gecontroleerd. Geschreven op basis van Google’s documentatie over soft 404-fouten en het rapport Pagina-indexering.
    Kort antwoord

    Een soft 404 is een pagina die de browser vertelt dat alles in orde is (HTTP 200), maar er voor Google uitziet als een ontbrekende of lege pagina. Google behandelt hem als “niet gevonden” en indexeert hem niet.

    De oplossing hangt af van wat de pagina écht is: weg? geef een echte 404 of 410. Verhuisd? 301 naar de meest vergelijkbare pagina. Echte pagina? geef hem genoeg echte inhoud.

    Wat een soft 404 is

    SERVER ZEGT

    200 OK — pagina bestaat

    Signaal: “Indexeer me, ik ben een normale pagina.”

    GOOGLE ZIET

    Leeg of “niet gevonden”

    Oordeel: de statuscode klopt niet, dus Google behandelt hem als 404.

    Wat de pagina echt is Juiste reactie Foute reactie
    Definitief weg 404 of 410 + uit de sitemap Redirect naar de homepage
    Vervangen door een andere pagina 301 naar het beste equivalent 301 naar iets willekeurigs
    Tijdelijk uitverkocht Live houden met volledige info Uitkleden tot één regel
    Echte pagina die leeg lijkt Rendering repareren / inhoud toevoegen Steeds opnieuw indexering aanvragen

    De zes gebruikelijke oorzaken

    • Eigen “niet gevonden”-pagina’s die 200 teruggeven in plaats van 404.
    • Lege categorie-, tag- of zoekpagina’s met alleen “Geen producten gevonden”.
    • Uitverkochte of verlopen items die zijn teruggebracht tot een titel en “niet meer leverbaar”.
    • Doorverwijzen naar een irrelevante pagina, vooral massaal verwijderde URL’s naar de homepage sturen.
    • Dunne placeholderpagina’s: “binnenkort beschikbaar”, bijna lege templates.
    • Weergaveproblemen. JavaScript dat voor Googlebot faalt, waardoor Google een lege pagina ziet.

    Oplossen per paginatype

    • Pagina bestaat niet meer? Geef een 404 of 410 en haal hem uit je sitemap en interne links.
    • Vervangen? 301 naar de meest vergelijkbare pagina — niet naar de homepage.
    • Webshop: houd tijdelijk uitverkochte producten online met volledige informatie, alternatieven en een verwachte leverdatum.
    • JavaScript-site: gebruik URL-inspectie → Live URL testen → Geteste pagina bekijken. Is de schermafbeelding leeg, los dan eerst de weergave op.
    • WordPress: controleer dat je 404-template echt een 404-status geeft, en zet lege tagarchieven op noindex.
    Onze mening
    Soft 404’s op pagina’s die toch weg horen zijn onschuldig. De pagina’s om op te lossen zijn échte pagina’s die Google voor leeg aanzag — en dat is bijna altijd een inhouds- of weergaveprobleem.

    Een uitgewerkt voorbeeld

    Een webshop haalt vijftig uitverkochte producten offline en stuurt alle oude URL’s naar de homepage. Twee weken later staan ze in Search Console als soft 404: de redirect zegt “verhuisd”, maar de homepage is geen vervanger voor een specifiek product. De juiste route was per product kiezen: is er een opvolger, stuur dan daarheen met een 301; is er alleen een passende categorie, stuur daarheen; is er niets vergelijkbaars, geef dan een echte 404 of 410 en haal de URL uit de sitemap. Na die correctie verdwijnen de meldingen vanzelf bij de volgende crawlronde — soft 404’s op bewust verwijderde pagina’s die netjes 404 geven, zijn daarna geen probleem meer.

    Veelgestelde vragen

    Is een soft 404 slecht voor SEO?

    Voor pagina’s die weg horen is het onschuldig maar slordig; een echte 404 of 410 is netter. Voor echte pagina’s is het wel slecht: Google indexeert ze pas als ze niet meer leeg lijken.

    Moet ik alle 404’s doorsturen naar de homepage?

    Nee. Google behandelt irrelevante doorverwijzingen naar de homepage meestal als soft 404. Verwijs alleen door naar een echt vergelijkbare pagina.

    Wat is het verschil tussen 404 en 410?

    Beide zeggen dat de pagina er niet is. 410 betekent “bewust en permanent weg”. In de praktijk behandelt Google beide als niet gevonden.

    Hoe laat ik Google opnieuw controleren?

    Los de pagina’s op en klik bij de melding op “Oplossing valideren”. Google crawlt de URL’s opnieuw; dat duurt meestal tot ongeveer twee weken.

    Waarom meldt Google een soft 404 op een bestaande pagina?

    Omdat de gerenderde pagina er voor Google leeg of als foutmelding uitziet: nauwelijks inhoud, een “niets gevonden”-tekst, of JavaScript dat voor Googlebot faalt.

    Verspillen soft 404’s crawlbudget?

    Ja, Googlebot blijft URL’s controleren die beweren te bestaan. Een echte 404 of 410 vertelt hem te stoppen.

    iP
    IndexUrePoint is een onafhankelijke gids over hoe je je pagina’s gevonden en geïndexeerd krijgt — Google, Bing en AI-zoeken. We testen tools zelf en zeggen het eerlijk wanneer iets niet werkt. Fout gespot? Laat het ons weten via de contactpagina; we verbeteren het en vermelden de datum.

  • Geblokkeerd door robots.txt (en “Geïndexeerd, maar geblokkeerd”): wat nu?

    Geblokkeerd door robots.txt (en “Geïndexeerd, maar geblokkeerd”): wat nu?

    Read this guide in English →

    Google Search Console · robots.txt

    “URL geblokkeerd door robots.txt” betekent dat je robots.txt Googlebot verbiedt de pagina te crawlen — en omdat robots.txt cràwlen regelt en niet indexeren, kan een geblokkeerde URL alsnog kaal in Google belanden.

    Belangrijkste punten
    • robots.txt stopt het crawlen; noindex stopt het indexeren. Die twee verwarren is dé klassieke robots-fout.
    • “Geïndexeerd, maar geblokkeerd door robots.txt” ontstaat als links wijzen naar een URL die Google niet mag lezen.
    • Wil je een pagina uit Google, dan moet je het crawlen juist toestaan zodat Google de noindex kan zien.
    • Veelgemaakte ongelukken: een achtergebleven Disallow: / van een testsite of een te brede voorvoegselregel.
    • Regels werken op het begin van het pad: Disallow: /blog blokkeert ook /blog-tips/.
    Hoe dit is gecontroleerd. Geschreven op basis van Google’s robots.txt-documentatie, de hulp bij het rapport Pagina-indexering en het robots.txt-rapport in Search Console.
    Kort antwoord

    “URL geblokkeerd door robots.txt” betekent dat je robots.txt Googlebot verbiedt deze URL te crawlen. Google kan de pagina dus niet lezen en indexeert de inhoud niet.

    “Geïndexeerd, maar geblokkeerd door robots.txt” is de vreemde tweeling: Google nam de URL toch op, meestal omdat andere pagina’s ernaar linken, zonder hem te kunnen lezen.

    De kernregel: robots.txt regelt crawlen, niet indexeren. Wil je een pagina uit Google houden, gebruik dan noindex — en laat Google de pagina crawlen zodat hij die tag kan zien.

    “URL geblokkeerd door robots.txt”

    Je robots.txt (op jouwsite.nl/robots.txt) bevat een Disallow-regel die op deze URL past. Voor beheerpagina’s, winkelwagens en interne zoekresultaten is dat precies de bedoeling. Voor artikelen en productpagina’s is het een fout.

    Veelvoorkomende ongelukjes: een achtergebleven Disallow: / van een testsite, een te brede regel zoals Disallow: /p die ook /producten/ raakt, of een plugin die het bestand herschreef.

    “Geïndexeerd, maar geblokkeerd door robots.txt”

    Google kan een URL indexeren die hij niet mag crawlen als er genoeg links naartoe wijzen. Hij toont dan de URL met weinig of geen beschrijving. Wat je doet hangt af van wat je wilt:

    JE WILT HEM IN GOOGLE

    Deblokkeren

    Oplossing: haal de Disallow-regel weg zodat Google kan crawlen en goed indexeren.

    JE WILT HEM WEG

    Deblokkeren + noindex

    Oplossing: sta crawlen toe en voeg noindex toe. Een geblokkeerde pagina kan zijn noindex niet laten zien.

    Doel robots.txt noindex Juiste keuze
    Pagina uit de zoekresultaten houden Onbetrouwbaar Ja Crawlen toestaan + noindex
    Crawlbudget sparen (filters, zoekpagina’s) Ja Geen effect op crawlen robots.txt Disallow
    Al geïndexeerde pagina verwijderen Maakt het erger Ja Deblokkeren + noindex, of 404/410
    AI-trainingsbots weren Ja (per user-agent) Nee robots.txt

    Beide statussen oplossen

    • Open het robots.txt-rapport in Search Console (Instellingen → robots.txt). Het toont welke versie Google ophaalde, wanneer, en eventuele fouten.
    • Zoek de regel die past. Regels werken op het begin van het pad: Disallow: /blog blokkeert ook /blog-tips/.
    • Pas voorzichtig aan. In WordPress kan dat via Yoast (Extra → Bestandseditor) of Rank Math. Blokkeer nooit CSS of JavaScript die je pagina’s nodig hebben.
    • Houd de sitemapregel erin: Sitemap: https://jouwsite.nl/sitemap_index.xml.
    • Valideer. Klik op “Oplossing valideren” of vraag indexering aan voor de belangrijkste pagina’s.
    Onze mening
    De grootste robots.txt-fout is het gebruiken om pagina’s te “verbergen”. Het verbergt niets — het maakt Google alleen blind. Gebruik robots.txt om crawlwerk te besparen en noindex om te bepalen wat in de zoekresultaten komt.

    Een uitgewerkt voorbeeld

    Een sitebeheerder wil interne zoekresultaten uit Google houden en zet Disallow: /?s= in robots.txt én een noindex op de zoekpagina’s. Klinkt dubbel veilig, maar het bijt elkaar: door de Disallow mag Google de pagina’s niet meer lezen en ziet hij de noindex dus nooit. URL’s met veel inkomende links kunnen dan als kale resultaten blijven staan — precies de melding “Geïndexeerd, maar geblokkeerd door robots.txt”. De juiste volgorde: eerst alleen de noindex laten staan tot de pagina’s uit de index zijn, en pàs daarna eventueel de Disallow toevoegen om crawlbudget te sparen. Andersom werkt het nooit.

    AI-crawlers: wil je GPTBot, ClaudeBot of Google-Extended apart toestaan of blokkeren, lees dan AI-crawlers en robots.txt — met voorbeeldregels per bot.

    Test je regels direct met onze gratis robots.txt-tester (Engels): je ziet welke regel een URL blokkeert voor Googlebot.

    Veelgestelde vragen

    Haalt robots.txt een pagina uit Google?

    Nee. robots.txt stopt alleen het crawlen. Een geblokkeerde URL kan via links toch geïndexeerd worden. Gebruik noindex, of verwijder de pagina en geef een 404 of 410.

    Moet ik AI-crawlers blokkeren in robots.txt?

    Dat kan, met regels voor hun eigen user-agents, maar het is een afweging: blokkeer je de crawler van een assistent, dan kom je niet in zijn antwoorden terecht.

    Hoe snel ziet Google wijzigingen in robots.txt?

    Google bewaart robots.txt doorgaans tot ongeveer een dag in de cache. Het robots.txt-rapport toont wanneer het laatst is opgehaald.

    Waar is de robots.txt-tester gebleven?

    Google heeft de oude tester vervangen door het robots.txt-rapport onder Instellingen in Search Console. URL-inspectie laat per URL zien of hij geblokkeerd is.

    Waar vind ik mijn robots.txt?

    Altijd in de root: jouwsite.nl/robots.txt. In WordPress kun je hem bewerken via Yoast (Extra → Bestandseditor) of Rank Math.

    Verbergt robots.txt een pagina voor bezoekers?

    Nee. Iedereen kan de URL gewoon openen en het robots.txt-bestand zelf is openbaar. Gebruik een login voor echt privémateriaal.

    iP
    IndexUrePoint is een onafhankelijke gids over hoe je je pagina’s gevonden en geïndexeerd krijgt — Google, Bing en AI-zoeken. We testen tools zelf en zeggen het eerlijk wanneer iets niet werkt. Fout gespot? Laat het ons weten via de contactpagina; we verbeteren het en vermelden de datum.

  • Welke URL houdt Google? Canonieke meldingen in Search Console uitgelegd

    Welke URL houdt Google? Canonieke meldingen in Search Console uitgelegd

    Read this guide in English →

    Google Search Console · Canonieke URL’s

    Ziet Google meerdere vrijwel identieke URL’s, dan indexeert hij er precies één: de canonieke versie. De drie canonieke meldingen in Search Console vertellen alleen wie die keuze maakte — jij, Google, of allebei eens.

    Belangrijkste punten
    • “Dubbele pagina zonder door de gebruiker geselecteerde canonieke versie”: jij gaf geen voorkeur op, Google koos zelf.
    • “Duplicaat, Google heeft een andere canonieke pagina gekozen”: jij wees, Google negeerde je hint.
    • “Alternatieve pagina met correcte canonieke tag”: jij wees, Google was het eens — meestal goed nieuws.
    • De oplossing is altijd dezelfde: laat canonical, sitemap, interne links en redirects dezelfde URL noemen.
    • Taalversies koppel je met hreflang, niet met een canonical: elke taal is zijn eigen canonieke pagina.
    Hoe dit is gecontroleerd. Geschreven op basis van Google’s documentatie over canonieke URL’s en het rapport Pagina-indexering (inclusief de officiële Nederlandse statuslabels).
    Kort antwoord

    Als Google meerdere bijna-identieke URL’s ziet, kiest hij er één om te indexeren: de canonieke versie. De rest wordt als duplicaat opzijgezet.

    Search Console toont drie varianten: “Dubbele pagina zonder door de gebruiker geselecteerde canonieke versie” (jij gaf geen voorkeur op), “Duplicaat, Google heeft een andere canonieke pagina gekozen dan de gebruiker” (Google negeerde jouw voorkeur) en “Alternatieve pagina met correcte canonieke tag” (alles werkt zoals bedoeld).

    De oplossing is bijna altijd hetzelfde: laat al je signalen naar dezelfde URL wijzen.

    Wat “canoniek” betekent

    Google groepeert pagina’s met (vrijwel) dezelfde inhoud en indexeert er één. Jij kunt een voorkeur aangeven met een rel=”canonical”-tag, je sitemap, interne links en doorverwijzingen. Maar Google behandelt die tag als een hint, geen bevel. Spreken je signalen elkaar tegen, dan kiest Google zelf.

    De drie meldingen — en wat ze betekenen

    GEEN VOORKEUR

    Dubbele pagina zonder canonieke versie

    Betekenis: je gaf geen canonical op, dus Google koos zelf. Deze URL verloor.

    GOOGLE KIEST ANDERS

    Google koos een andere canonieke pagina

    Betekenis: je canonical wijst de ene kant op, Google koos de andere.

    De derde, “Alternatieve pagina met correcte canonieke tag”, is meestal goed nieuws: de pagina verwijst netjes naar een andere canonieke versie en Google is het ermee eens. Die kun je doorgaans negeren — tenzij er een unieke pagina tussen staat die je juist wél in Google wilt.

    Melding Wie koos? Actie
    Dubbele pagina zonder canonieke versie Google (jij zei niets) Zelfverwijzende canonicals toevoegen
    Google koos een andere canonieke pagina Google (tegen jouw hint in) Signalen gelijktrekken, URL versterken
    Alternatieve pagina met correcte tag Jij, met Google’s zegen Meestal niets

    Welke heb jij? Controle in 60 seconden

    Open de URL in URL-inspectie. Vergelijk “Door gebruiker opgegeven canonieke URL” met “Door Google geselecteerde canonieke URL”.
    Het is een ongewenste variant
    1. Parameter-, tracking- of filter-URL?
    2. Koos Google je echte pagina?
    3. Dan werkt het zoals bedoeld.
    Het is een pagina die je wilt laten ranken
    1. Is de inhoud echt uniek?
    2. Verwijst de canonical naar zichzelf?
    3. Linken sitemap en interne links naar deze URL?

    Oplossingen die werken (in deze volgorde)

    • Laat je signalen overeenkomen. Sitemap, canonical, interne links en doorverwijzingen moeten allemaal dezelfde URL noemen. Tegenstrijdige signalen zijn de nummer-één-oorzaak.
    • Geef elke belangrijke pagina een canonical naar zichzelf. Yoast SEO en Rank Math doen dit automatisch; controleer de paginabron op rel=”canonical”.
    • Ruim dubbele varianten op. http en https, www en zonder www, met en zonder slash aan het eind: stuur alles met een 301 door naar één versie.
    • Versterk de URL die je wilt. Link er intern naartoe vanaf sterke, al geïndexeerde pagina’s.
    • Voeg echte duplicaten samen. Twee bijna gelijke pagina’s? Maak er één sterke pagina van en verwijs de andere door.
    • Taalversies? Elke taalversie is zijn eigen canonieke pagina; koppel ze met hreflang, niet met een canonical.
    Onze mening
    Blijf niet op “Indexering aanvragen” drukken in de hoop dat Google van gedachten verandert. Dat gebeurt niet. Los de tegenstrijdige signalen op en geef Google één nieuwe crawlronde.

    Veelgestelde vragen

    Schaden deze meldingen mijn rankings?

    Niet direct: de inhoud rankt via de URL die Google koos. Het wordt pas een probleem als Google een zwakkere of verkeerde versie kiest, of als linkwaarde over duplicaten wordt verdeeld.

    Dwingt een canonical-tag Google om te gehoorzamen?

    Nee. Het is een sterke hint, geen opdracht. Als links, sitemap en doorverwijzingen iets anders zeggen, kan Google de tag negeren.

    Moet ik “Alternatieve pagina met correcte canonieke tag” oplossen?

    Meestal niet. Het bevestigt dat je canonicals werken. Alleen als er een unieke pagina tussen staat die je wilt laten ranken, klopt de canonical van die pagina niet.

    Hoe lang duurt het voordat Google zijn keuze aanpast?

    Na het rechttrekken van je signalen meestal dagen tot enkele weken, afhankelijk van hoe snel Google beide URL’s opnieuw crawlt.

    Kan ik zien welke canonieke URL Google koos?

    Ja. URL-inspectie in Search Console toont de door jou opgegeven én de door Google geselecteerde canonieke URL naast elkaar.

    Veroorzaken URL-parameters een duplicate-content-boete?

    Nee. Parameters maken dubbele URL’s, geen boetes. Google vouwt ze samen tot één canonieke versie; jouw taak is zorgen dat dat de juiste is.

    iP
    IndexUrePoint is een onafhankelijke gids over hoe je je pagina’s gevonden en geïndexeerd krijgt — Google, Bing en AI-zoeken. We testen tools zelf en zeggen het eerlijk wanneer iets niet werkt. Fout gespot? Laat het ons weten via de contactpagina; we verbeteren het en vermelden de datum.

  • URL gemarkeerd als ‘noindex’: vinden, weghalen en toch geïndexeerd worden

    URL gemarkeerd als ‘noindex’: vinden, weghalen en toch geïndexeerd worden

    Read this guide in English →

    Google Search Console · noindex

    “URL gemarkeerd als noindex” betekent dat Google je pagina heeft gecrawld, een instructie vond om hem niet te indexeren en die heeft opgevolgd — de enige vraag is of jij die instructie bewust hebt geplaatst.

    Belangrijkste punten
    • Bewuste noindex (bedankpagina’s, archieven) vraagt geen actie; een per ongeluk genoindexte geldpagina is met één instelling gerepareerd.
    • Een noindex verstopt zich op vier plekken: de robots-metatag, de X-Robots-Tag-header, “Zoekmachines ontmoedigen” en je SEO-plugin.
    • Repareer de bron, niet de pagina: een berichttype op noindex zet elk nieuw bericht opnieuw op noindex.
    • De pagina moet crawlbaar blijven — blokkeer je hem in robots.txt, dan ziet Google nooit dat de noindex weg is.
    • Na de fix: cache legen en voor belangrijke pagina’s indexering aanvragen.
    Hoe dit is gecontroleerd. Geschreven op basis van Google’s documentatie over de noindex-richtlijn en het rapport Pagina-indexering, en getoetst aan hoe Yoast SEO, Rank Math en WordPress robots-metatags uitvoeren.
    Kort antwoord

    “URL gemarkeerd als ‘noindex’” betekent dat Google de pagina heeft gecrawld, een instructie vond om hem niet te indexeren, en die heeft opgevolgd.

    Is dat de bedoeling (bedankpagina’s, tagarchieven, privépagina’s), dan hoef je niets te doen. Is het een pagina die je wél in Google wilt, zoek dan waar de noindex vandaan komt — je SEO-plugin, een WordPress-instelling of een HTTP-header — haal hem weg en vraag indexering aan.

    Wat de melding betekent

    BEWUST

    Laten staan

    Voorbeelden: inlog-, winkelwagen- en bedankpagina’s, interne zoekresultaten, dunne archieven.

    PER ONGELUK

    Nu oplossen

    Voorbeelden: blogartikelen, productpagina’s, je homepage — alles wat verkeer moet opleveren.

    Waar een noindex zich verstopt

    • De robots-metatag in de HTML: <meta name=”robots” content=”noindex”>. Bekijk de paginabron en zoek op “noindex”.
    • De X-Robots-Tag-header, ingesteld door server, CDN of plugin. Onzichtbaar in de paginabron — URL-inspectie laat het zien bij “Indexeren toegestaan?”.
    • “Zoekmachines ontmoedigen” in WordPress (Instellingen → Lezen). Eén vinkje dat de hele site op noindex zet.
    • Instellingen van je SEO-plugin. Yoast: “Zoekmachines toestaan deze inhoud in zoekresultaten te tonen?” per bericht en per inhoudstype. Rank Math: de Robots Meta-instelling.
    • Onderhouds- of “binnenkort beschikbaar”-plugins die zolang ze actief zijn een noindex toevoegen.
    Waar de noindex zit Zo controleer je het Zo los je het op
    Robots-metatag in de HTML Paginabron, zoek “noindex” Per-bericht-instelling in je SEO-plugin
    X-Robots-Tag-header URL-inspectie → “Indexeren toegestaan?” Server-/CDN-/plugininstelling
    WordPress → Lezen Vinkje “Zoekmachines ontmoedigen” Vinkje uitzetten
    Standaard per berichttype SEO-plugin → Weergave in zoekresultaten Type op indexeerbaar zetten

    Stap voor stap weghalen

    • Bevestig het met URL-inspectie (live test). Daar zie je of de noindex in de metatag of in de header zit.
    • Los de bron op, niet alleen de pagina. Staat een heel berichttype op noindex, dan erft elk nieuw bericht dat.
    • Leeg je cache. Paginacache en CDN kunnen de oude HTML nog even serveren.
    • Zorg dat de pagina niet in robots.txt geblokkeerd is — Google moet hem kunnen crawlen om de wijziging te zien. Zie Geblokkeerd door robots.txt.
    • Vraag indexering aan voor belangrijke pagina’s en klik op “Oplossing valideren” voor de rest.
    Onze mening
    Een verdwaalde noindex is het goedkoopste indexeringsprobleem dat er is: één instelling, direct op te lossen. Daarom is het stap één in onze gids Website aanmelden bij Google.

    Een uitgewerkt voorbeeld

    Een bedrijf lanceert zijn nieuwe site en de weken erna komt er geen enkele pagina in Google. Paniek, backlinks gekocht, niets helpt. De echte oorzaak: tijdens de bouw stond “Zoekmachines ontmoedigen om deze site te indexeren” aan, en niemand zette het vinkje na de lancering uit. Eén instelling, weken verlies. Daarom is dit de eerste controle in elke indexeringsdiagnose: Instellingen → Lezen in WordPress, daarna URL-inspectie op de homepage. Staat daar “Indexeren toegestaan? Nee: ‘noindex’ gedetecteerd”, dan weet je binnen een minuut waar je moet zijn — en na het uitzetten en opnieuw aanvragen stonden in dit soort gevallen de eerste pagina’s er binnen dagen in.

    Veelgestelde vragen

    Hoe snel wordt de pagina geïndexeerd na het weghalen van noindex?

    Google moet de pagina eerst opnieuw crawlen. Met Indexering aanvragen gaat dat vaak binnen dagen; minder belangrijke pagina’s kunnen weken duren.

    Is noindex hetzelfde als blokkeren in robots.txt?

    Nee. noindex zegt “toon dit niet in zoekresultaten” en vereist dat de pagina gecrawld wordt. robots.txt zegt “crawl dit niet” en houdt een URL niet betrouwbaar uit de index.

    Moet ik tag- en categoriepagina’s op noindex zetten?

    Alleen als ze dun of dubbel zijn. Nuttige categoriepagina’s met een eigen introductie kunnen goed ranken.

    Geldt noindex ook voor Bing?

    Ja. Bing en andere grote zoekmachines respecteren de robots-metatag en de X-Robots-Tag-header op dezelfde manier.

    Is een noindex een straf van Google?

    Nee, het is een instructie die je eigen site meestuurt. Google gehoorzaamt simpelweg; haal hem weg en de pagina komt weer in aanmerking voor indexering.

    Moet ik noindex combineren met nofollow?

    Meestal niet: met alleen noindex blijven de links op de pagina signalen doorgeven. Parkeer belangrijke pagina’s niet langdurig op noindex.

    iP
    IndexUrePoint is een onafhankelijke gids over hoe je je pagina’s gevonden en geïndexeerd krijgt — Google, Bing en AI-zoeken. We testen tools zelf en zeggen het eerlijk wanneer iets niet werkt. Fout gespot? Laat het ons weten via de contactpagina; we verbeteren het en vermelden de datum.