Nieuw hier? Begin met Website aanmelden bij Google →
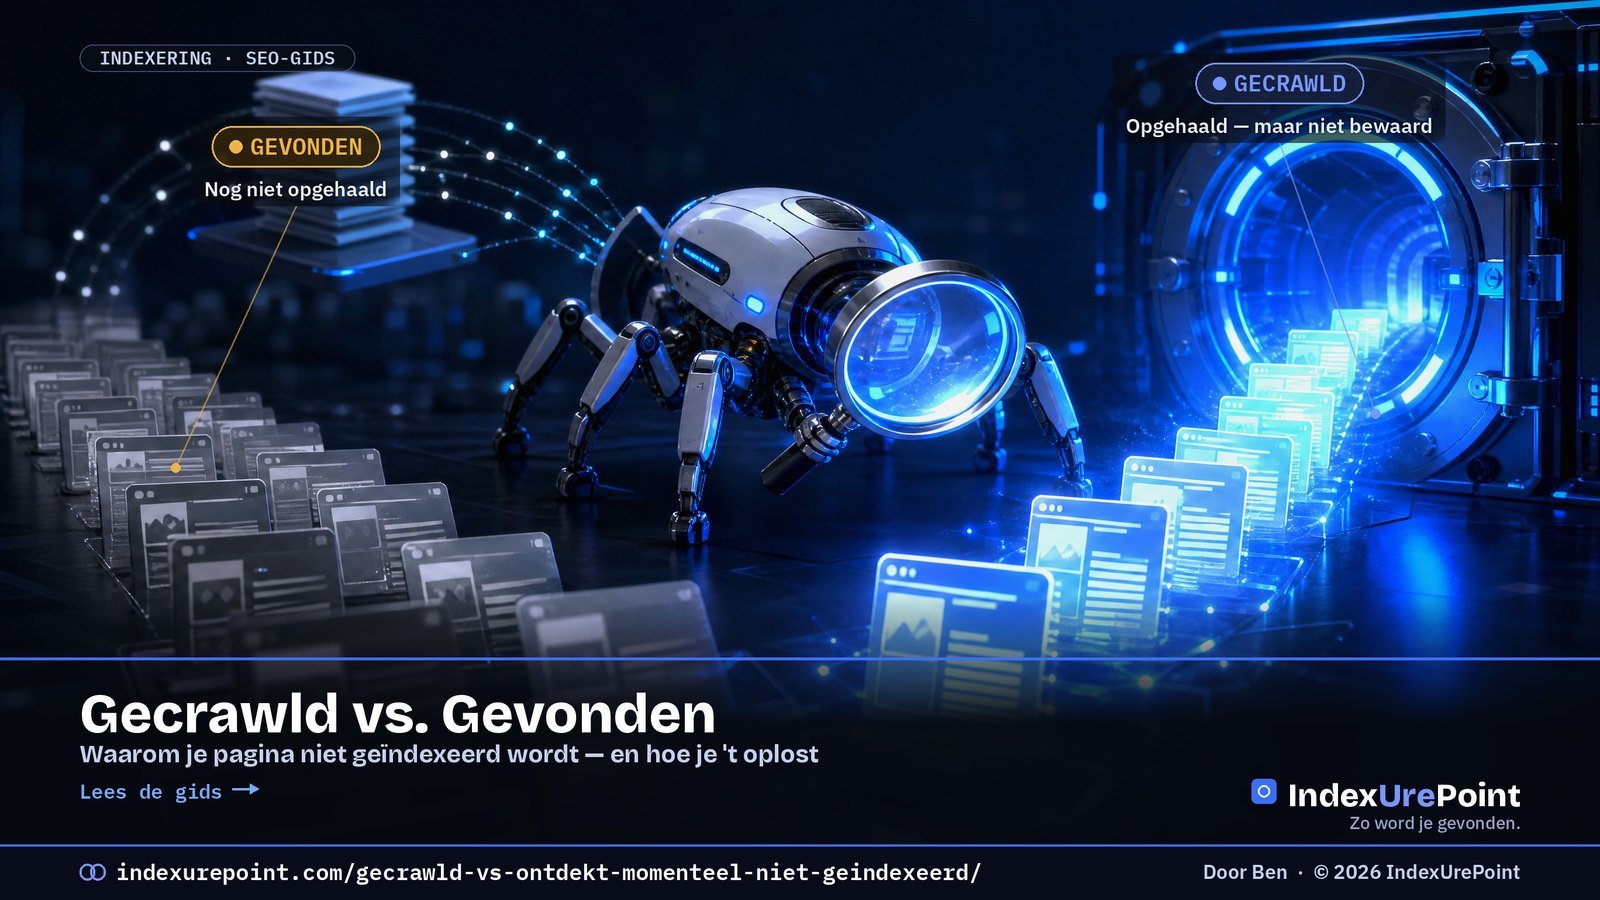
“Gevonden – momenteel niet geïndexeerd” betekent dat Google je URL kent maar nooit heeft opgehaald; “Gecrawld – momenteel niet geïndexeerd” betekent dat Google de pagina wél heeft opgehaald en hem niet wilde bewaren. Dat ene verschil — opgehaald of niet — bepaalt welke oplossing werkt.
- Gevonden = een vindbaarheids-/prioriteitsprobleem: oplossen met interne links en crawlprioriteit, niet met tekstwijzigingen.
- Gecrawld = een waardeprobleem: Google zag de pagina en sloeg hem over. Verbeter of voeg de inhoud samen.
- Google zegt zelf dat indexeren “enkele dagen tot enkele weken” kan duren — op nieuwe sites is wachten vaak het juiste antwoord.
- In de Reddit-draadjes die we analyseerden zitten pagina's 2,5 week tot 3+ maanden vast; één programmatische site had 29 pagina's die na 8+ weken nog nooit waren opgehaald.
- De vaakst genoemde oplossing op r/SEO en r/bigseo: interne links vanaf sterke, al geïndexeerde pagina's — niet opnieuw indienen via URL-inspectie.
“Gevonden – momenteel niet geïndexeerd” betekent dat Google weet dat je URL bestaat, maar hem nog niet heeft opgehaald — meestal een kwestie van crawlbudget of lage prioriteit. De pagina is nooit opgehaald.
“Gecrawld – momenteel niet geïndexeerd” betekent dat Google de pagina wél heeft opgehaald en er daarna voor koos om hem niet te indexeren — meestal een signaal over kwaliteit, duplicatie of dunne inhoud.
Dat ene verschil — opgehaald of niet — bepaalt je oplossing. Gevonden is een vindbaarheids-/prioriteitsprobleem; Gecrawld is een waardeprobleem.
Het verschil dat telt
Welke van de twee heb jij?
Oplossingen die écht werken
De Indexing-API-“truc”
Wanneer het normaal is
Veelgestelde vragen
Het ene verschil dat je oplossing verandert
Beide statussen staan in hetzelfde rapport van Google Search Console, en mensen behandelen ze als hetzelfde probleem. Dat zijn ze niet. De scheidslijn is één vraag: heeft Googlebot de pagina daadwerkelijk opgehaald?
Gevonden, niet opgehaald
Wat het betekent: Google zag de URL (in je sitemap of via een link) maar heeft hem nog niet gecrawld. Hij staat in de wachtrij.
Opgehaald, niet bewaard
Wat het betekent: Google heeft de pagina gecrawld, beoordeeld en besloten hem (nog) niet aan de index toe te voegen.
Krijg je dit helder, dan wordt de rest eenvoudiger. Jagen op “crawlbudget” terwijl je echte probleem dunne inhoud is, kost je weken — een punt dat praktijkmensen op r/bigseo telkens maken over pagina’s die “8+ weken vastzitten” en die geen enkele herindiening losmaakt.
Welke van de twee heb jij? Een beslissing in 30 seconden
- Is de URL binnen ≤3 klikken vanaf je homepage te bereiken?
- Staat hij in je sitemap en krijgt hij interne links?
- Is je server snel en foutvrij in de logs?
- Is de inhoud wezenlijk uniek t.o.v. andere pagina’s?
- Beantwoordt hij een echte zoekvraag beter dan wat nu rankt?
- Is hij canoniek, of een bijna-duplicaat van een andere URL?
Beantwoord de drie vragen in jouw kolom. Elke “nee” is een knop waar je aan kunt draaien — in de volgorde waarin ze staan.
Oplossingen die écht werken (en de volgorde om ze te proberen)
Is het Gevonden — maak de pagina makkelijk en de moeite waard om te bereiken
- Voeg interne links toe vanaf sterke, al geïndexeerde pagina’s. Dit is de meest genoemde fix in praktijkdraadjes: een link vanaf een pagina die Google al vertrouwt trekt de vastzittende URL sneller de crawlwachtrij in dan opnieuw indienen ooit doet.
- Maak de klikdiepte kleiner. Pagina’s die 5+ klikken diep zitten lezen als lage prioriteit. Haal ze naar voren vanaf hubs en categoriepagina’s.
- Controleer je serverlogs op verspild crawlbudget. Als Googlebot zijn budget verbrandt aan parameter-URL’s, facetfilters of 5xx-fouten, verhongeren je goede pagina’s. Blokkeer de rommel in robots en los de fouten op.
Is het Gecrawld — geef Google een reden om hem te bewaren
- Verhoog de unieke waarde van de pagina. Voeg eigen inzicht, data of een helderder antwoord toe dan de huidige topresultaten. “Gecrawld – niet geïndexeerd” is vaak Google die zegt dit hebben we al.
- Voeg dunne of bijna-dubbele pagina’s samen. Tien oppervlakkige pagina’s die elk worden afgewezen zijn slechter dan één sterke pagina. Samenvoegen en doorverwijzen.
- Los canonieke verwarring op. Als twee URL’s er voor Google hetzelfde uitzien, houdt hij er één en laat de ander vallen. Maak je canonicals expliciet.
- Dan — en pas dan — vraag indexering aan. Gebruik URL-inspectie spaarzaam zodra de pagina het echt verdient. Een zwakke pagina opnieuw indienen verandert niets.
Op r/SEO is de terugkerende conclusie dat aanhoudend “gecrawld – niet geïndexeerd” op een verder gezonde site meestal geen technische storing is — het is Google’s oordeel over inhoudskwaliteit of domeinautoriteit. De oplossing is zelden een knop; het is dat de pagina het indexeren waard is.
De Indexing-API-“truc” — waarom hij verleidelijk is, en waarom hij averechts kan werken
Je vindt gidsen (en Reddit-draadjes) die laten zien hoe je pagina’s naar binnen forceert via Google’s Indexing API — een stappenplan met een serviceaccount en een batch URL’s. Op korte termijn kan het werken. Maar twee dingen zijn waar en worden meestal weggelaten:
- Google’s eigen documentatie zegt dat de Indexing API alleen bedoeld is voor JobPosting– en BroadcastEvent-pagina’s. Hem gebruiken voor gewone berichten is oneigenlijk.
- Google heeft een expliciete spamwaarschuwing aan die documentatie toegevoegd. Misbruik kan je veel meer kosten dan de pagina’s waard waren.
Behandel de Indexing-API-route als een rode vlag, niet als een sluiproute. Als een pagina een omweg nodig heeft om geïndexeerd te worden, is dat een signaal dat de pagina — of de autoriteit van de site — er nog niet is. Pak de oorzaak aan.
Wanneer “niet geïndexeerd” volkomen normaal is
Niet elke niet-geïndexeerde URL is een probleem. Nieuwe sites en nieuwe pagina’s staan dagen tot enkele weken in deze statussen terwijl Google de site inschat. Is je pagina een week oud op een jong domein, dan is het eerlijke antwoord: blijf publiceren, blijf links verdienen, en wacht. Elke dag in paniek opnieuw indienen doet niets, behalve jou onrustig maken.
| Search Console-status | Opgehaald door Googlebot? | Oorzaak | Werkende oplossing |
|---|---|---|---|
| Gevonden – momenteel niet geïndexeerd | Nee | Crawlprioriteit / vindbaarheid | Interne links, sitemap, klikdiepte verkleinen |
| Gecrawld – momenteel niet geïndexeerd | Ja | Kwaliteits-/duplicaatoordeel | Inhoud verbeteren of samenvoegen, canonicals |
| URL gemarkeerd als noindex | Ja | Je pagina zegt “blijf weg” | Noindex weghalen, opnieuw laten crawlen |
| Geblokkeerd door robots.txt | Nee (niet toegestaan) | Crawlregel | Disallow-regel corrigeren |
Wat werkte er volgens praktijkmensen écht?
We hebben de Reddit-draadjes achter deze gids in september 2026 via een gestructureerde bronanalyse (NotebookLM) doorgenomen. Op r/SEO, r/bigseo, r/TechSEO en r/localseo komen vijf oplossingen steeds terug als degene die vastzittende pagina’s écht losmaakten:
- Interne links vanaf sterke pagina’s. “I had this issue until I added more internal linking.” (r/SEO)
- Een kleine wijziging in de slug, waardoor Google de URL als nieuw behandelt: “The only way I have to fix them is a slight slug edit.” (r/bigseo)
- Een paar backlinks naar de vastzittende pagina: “Just sent a couple of backlinks to the page and it was fixed.” (r/SEO)
- Laadtijd repareren. Een site-eigenaar met laadtijden van 2–3 minuten: “About 3 days later, all the pages were indexed again.” (r/SEO)
- De Indexing API — één r/TechSEO-test meldde 94% geïndexeerd binnen 48 uur tegenover 8,4% via de sitemap. Het werkt op korte termijn, maar valt buiten Google’s regels voor gewone pagina’s; het risico leggen we uit in het hoofdstuk hierboven.
De schaal loopt enorm uiteen: van 3 vastzittende pagina’s op een lokale bedrijfssite tot 29 op een programmatische site na 8+ weken en 8.000 op een nieuwssite. En de frustratie over algemeen advies is echt — “Anyone solved this beyond ‘earn backlinks and wait’?” (r/bigseo). Precies daarom telt de tweedeling hierboven: bepaal eerst wélke status je hebt, en pas dan de bijpassende oplossing toe.
Veelgestelde vragen
Hoe lang moet ik wachten voordat ik me zorgen maak?
Op een gevestigde site indexeert een echt waardevolle, intern gelinkte pagina meestal binnen dagen tot twee weken. Op een gloednieuw domein zijn enkele weken normaal. Maak je zorgen als een goed gelinkte pagina met hoge waarde langer dan ~3–4 weken blijft vastzitten.
Lost “gecrawld – momenteel niet geïndexeerd” zichzelf op?
Soms — Google herbeoordeelt na verloop van tijd. Maar als de oorzaak dunne of dubbele inhoud is, helpt wachten niet. Verbeter eerst de waarde van de pagina en laat Google hem daarna opnieuw crawlen.
Lost een betaalde indexeringsdienst het op?
Zelden, en niet blijvend. Die diensten helpen vooral om backlinks ontdekt te krijgen, niet om je eigen dunne pagina’s geaccepteerd te krijgen. Heeft Google je pagina gecrawld en afgewezen, dan verandert er opnieuw pingen niets aan zijn oordeel. In onze reviews leggen we eerlijk uit welke dienst wat doet.
Is “Gevonden” of “Gecrawld” het ergere probleem?
Geen van beide is inherent erger — het zijn verschillende klussen. Gevonden is meestal de makkelijkere fix (interne links, crawlbudget). Gecrawld betekent dat Google de pagina al heeft beoordeeld, dus dat kan meer werk kosten.
Wat is het verschil tussen Gevonden en Gecrawld – momenteel niet geïndexeerd?
Gevonden betekent dat Google de URL kent maar nog niet heeft opgehaald: een crawlprioriteitsprobleem. Gecrawld betekent dat Google de pagina heeft opgehaald en beoordeeld, maar niet wilde indexeren: een waardeprobleem.
Helpt het aanpassen van de slug echt om een pagina geïndexeerd te krijgen?
Praktijkmensen op r/bigseo melden dat een kleine slug-wijziging kan werken omdat Google de nieuwe URL als verse pagina behandelt. Het is een omweg, geen oplossing: het onderliggende probleem blijft meestal bestaan.
Hoeveel vastzittende pagina's is normaal?
Op grote of programmatische sites kunnen honderden of duizenden uitgesloten URL's normaal zijn. Maak je zorgen als goed gelinkte pagina's die je wilt laten ranken na drie à vier weken op een gevestigde site nog vastzitten.
Comments
2 responses to “Gecrawld vs. Gevonden — momenteel niet geïndexeerd: wat het betekent en hoe je het oplost”
[…] Lees deze gids in het Nederlands → […]
[…] Maak je zorgen als een goed gelinkte, waardevolle pagina op een gevestigde site na 3–4 weken nog niet is geïndexeerd. Kijk dan naar de status in Search Console: staat er Ontdekt, dan is het een prioriteitsprobleem; staat er Gecrawld – momenteel niet geïndexeerd, dan is het een waardeprobleem. Beide leggen we uit in Gecrawld vs. Ontdekt. […]